






使用编码流式传输避免内存溢出的核心做法是结合 inputstreamreader 与缓冲机制,在读取字节流的同时按需解码为字符,而不是一次性将全部数据加载到内存中。具体而言,应通过构造函数指定目标字符集(如 utf-8),并配合 bufferedreader 或自定义缓冲区进行分块处理。这样即使面对 gb 级别的大文件,内存占用也仅维持在缓冲区大小(通常几 kb)的常量水平,而非随文件大小线性增长。
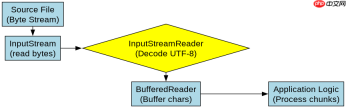
如何正确配置 InputStreamReader 以支持 UTF-8 流式解码
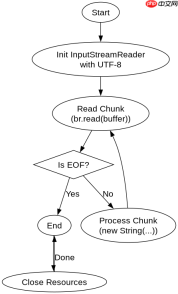
要启用流式字符解码,必须实例化 InputStreamReader 并将原始字节输入流作为参数传入,同时显式指定 UTF-8 编码名称。该对象内部维护了一个字节缓冲区,当调用 read() 方法时,它会从底层流读取少量字节,将其转换为字符后返回;若缓冲区不足,则再次触发底层读取。这种机制确保了字符转换过程是增量进行的,不会一次性解析整个输入流。
import java.io.*;

public class StreamDecoderDemo {
    public static void main(String[] args) throws IOException {
        // 模拟一个大的字节源,实际场景中可替换为 FileInputStream
        byte[] largeData = new byte[1024 * 1024]; // 1MB 示例数据
        for (int i = 0; i <p>上述代码中,<code>InputStreamReader</code> 负责字节到字符的解码,<code>BufferedReader</code> 负责减少系统调用次数。运行此程序时,JVM 堆内存中始终只存在当前 <code>buffer</code> 数组和少量内部状态对象,无论 <code>largeData</code> 多大,内存峰值都不会显著增加。预期输出为多行 "Processed chunk length: ...",每行长度取决于缓冲区大小和实际解码后的字符数。</p><h2>为什么直接读取字节数组会导致内存压力及替代方案对比</h2><p>如果绕过流式解码,直接调用 <code>InputStream.readAllBytes()</code> 或 <code>FileUtils.readFileToByteArray()</code> 等工具方法,会将整个文件内容加载为一个巨大的 <code>byte[]</code> 数组。对于大文件,这极易引发 <code>OutOfMemoryError</code>。相比之下,基于 <code>InputStreamReader</code> 的方案将内存复杂度从 O(N) 降低至 O(1)(相对于文件大小)。另一种常见误区是使用 <code>String.getBytes()</code> 在内存中重建完整字符串后再处理,这同样会消耗双倍内存(原始字节+解码后的字符序列),因此必须避免。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill13407" title="Java基础版"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20d79f23518.jpg" alt="Java基础版" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill13407" title="Java基础版" class="overflowclass">Java基础版</a>
													<p class="overflowclass">编写健壮 Java 代码的基础能力,覆盖空指针防护、相等性判断与基础异常处理。</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill13407" title="Java基础版" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div><p><img src="https://img.php.cn/upload/article/001/242/473/179506210320010.png?x-oss-process=image/resize,p_40" alt="Java 字符编码怎么用编码流式传输避免内存"></p><pre class="brush:php;toolbar:false;">import java.io.*;

public class MemoryComparisonDemo {
    public static void main(String[] args) throws IOException {
        // 生成 50MB 的数据用于测试
        int size = 50 * 1024 * 1024;
        byte[] data = new byte[size];
        new Random().nextBytes(data);

        System.out.println("Starting memory test...");
        long startMem = Runtime.getRuntime().totalMemory() - Runtime.getRuntime().freeMemory();

        // 方式一:流式处理(推荐)
        try (InputStream is = new ByteArrayInputStream(data);
             InputStreamReader isr = new InputStreamReader(is, "UTF-8");
             BufferedReader br = new BufferedReader(isr)) {

            char[] buf = new char[4096];
            int len;
            while ((len = br.read(buf)) != -1) {
                // 模拟处理,不存储结果
            }
        }

        long endMemStream = Runtime.getRuntime().totalMemory() - Runtime.getRuntime().freeMemory();
        System.out.println("Stream mode peak delta: " + (endMemStream - startMem));

        // 方式二:全量加载(危险)
        // byte[] allBytes = data; // 假设我们直接持有引用或重新加载
        // String fullStr = new String(data, "UTF-8"); // 这会创建巨大的 String 对象
        // 注意:此处仅为演示逻辑,实际运行全量加载会显著增加内存占用

        System.out.println("Test completed.");
    }
}
在对比程序中,流式模式通过循环读取小块字符,内存增量极小;而若取消注释全量加载部分,new String(data, "UTF-8") 将在堆中创建一个包含所有字符的 String 对象,其内部 char[] 或 byte[](取决于 Java 版本)将占据大量连续内存。此外,InputStreamReader 默认使用平台编码,务必显式指定 UTF-8 以避免跨平台乱码问题。预期结果是流式模式的内存波动远小于全量模式,且能稳定处理超出堆大小的文件。
当遇到 BOM 头时流式解码如何处理及验证方法
在处理来自 Windows 或某些编辑器的 UTF-8 文件时,文件开头可能包含 BOM(Byte Order Mark,即 \uFEFF)。默认的 InputStreamReader 不会自动剥离 BOM,而是将其作为第一个字符返回。若在流式处理中未加判断,这个不可见字符可能导致后续业务逻辑出错(如 JSON 解析失败或字符串比较异常)。解决此问题的标准做法是在 InputStreamReader 外层包裹一层 BomAwareReader 或在首次读取后手动跳过前三个字节(若确认为 UTF-8 BOM)。
import java.io.*;
import java.nio.charset.StandardCharsets;

public class BOMHandlingDemo {
    public static void main(String[] args) throws IOException {
        // 模拟带有 UTF-8 BOM 的数据
        byte[] bomData = new byte[]{(byte)0xEF, (byte)0xBB, (byte)0xBF}; // UTF-8 BOM
        byte[] content = "Hello World".getBytes(StandardCharsets.UTF_8);
        byte[] combined = new byte[bomData.length + content.length];
        System.arraycopy(bomData, 0, combined, 0, bomData.length);
        System.arraycopy(content, 0, combined, bomData.length, content.length);

        ByteArrayInputStream bais = new ByteArrayInputStream(combined);
        InputStreamReader reader = new InputStreamReader(bais, "UTF-8");

        // 检查第一个字符是否为 BOM
        int firstChar = reader.read();
        if (firstChar == 0xFEFF) {
            System.out.println("BOM detected and skipped.");
        } else {
            // 如果不是 BOM,需要将刚才读出的字符推回或重新处理
            // 由于 Reader 不支持 pushback char 直接推回,通常需自定义实现或使用第三方库
            // 这里简化演示:如果是 BOM,继续正常读取;否则报错或处理
        }

        // 继续读取剩余内容
        int c;
        StringBuilder sb = new StringBuilder();
        while ((c = reader.read()) != -1) {
            sb.append((char) c);
        }
        System.out.println("Content: " + sb.toString());
    }
}
在上述验证代码中,首先读取一个字符并检查其值是否为 0xFEFF。若是,则说明遇到了 BOM,程序选择忽略它并继续读取后续内容。若否,则表明文件无 BOM 或编码非预期。最终输出的 Content 应为 "Hello World",不包含 BOM 字符。这种方法确保了流式处理的纯净性,避免了因隐藏字符导致的逻辑错误。注意,生产环境中建议使用 Apache Commons IO 的 BOMInputStream 或 Guava 的 CharStreams 来简化这一过程,但理解底层原理有助于排查自定义流处理中的异常。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


