






使用 -xlog:gc+age 可以输出详细的 gc 日志,其中包含各年龄代(age)的存活对象数量分布。要获取年龄分布数据,需配合 -xx:+printgcdetails 和 -xlog:gc*=debug:file=gc.log 参数启动 jvm,日志中会按 generation 和 age 统计每个区间的对象数及大小。

如何配置参数以启用年龄分布日志
在 Java 9 及以上版本中,推荐使用 -Xlog 统一日志框架。要看到年龄分布,必须开启 gc+age 标签。同时建议指定输出文件以便后续分析。例如,运行以下命令可生成包含年龄分布的日志:java -Xlog:gc*=debug:file=gc.log:time,uptime,level,tags -XX:+PrintGCDetails YourApp。日志中每一行 GC 事件后通常会跟随一个表格,列出各代的容量、已用空间以及按年龄分组的对象统计。
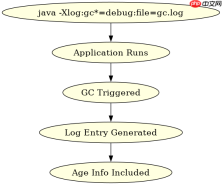
java -Xlog:gc*=debug:file=gc.log:time,uptime,level,tags -XX:+PrintGCDetails -jar app.jar
上述命令会在当前目录生成 gc.log。打开日志文件,查找类似以下的片段:
[0.123s][info][gc,age] PSYoungGen: 10240K->1024K(15360K) OldGen: 204800K->204800K(204800K) [0.123s][info][gc,age]   Age 1: 1024 objects, 10240 bytes
   Age 2: 512 objects, 5120 bytes
   ...
这里 Age 1 到 Age N 即为年龄分布。每个条目显示该年龄层的对象数量和占用字节数。通过观察这些数值的变化,可以判断对象晋升是否符合预期。

如何解析日志中的年龄分布表格
日志中的年龄分布通常紧跟在 GC 摘要之后。以 G1 GC 为例,其格式可能略有不同,但核心信息一致。G1 日志中可能会直接列出各个 Humongous 区域或年轻代内部的年龄统计。对于 Parallel Scavenge 或 Serial GC,年龄分布通常在 Young Gen 部分详细列出。解析时,关注 Age 关键字后的数字序列。如果某个年龄层的对象数量突然激增,可能意味着该层存在大量长生命周期对象,或者晋升阈值设置不当。此外,注意总对象数是否等于 Young Gen 的存活对象总数,这有助于验证数据的完整性。

// 模拟解析逻辑伪代码
if (line.contains("Age")) {
    parse age distribution from line;
    update histogram;
}
在实际操作中,可以使用脚本如 Python 或 AWK 提取这些行。例如,使用 grep "Age" gc.log 可以快速过滤出所有年龄分布行。然后逐行解析,将年龄作为键,对象数量作为值,构建直方图。这样能直观地看到对象在不同年龄层的分布情况,辅助调优 GC 参数如 -XX:MaxTenuringThreshold。
年龄分布异常对 GC 性能的影响
当年龄分布出现极端情况时,会对 GC 性能产生显著影响。例如,如果大部分对象都集中在最高年龄层(如 Age 15),说明晋升机制过于激进,导致年轻代空间迅速耗尽,频繁触发 Full GC。反之,如果低年龄层对象堆积,可能意味着回收效率低下。通过分析 -Xlog:gc+age 输出的分布,可以调整 -XX:TargetSurvivorRatio 或 -XX:MaxTenuringThreshold 来优化晋升策略。确保对象在合适的年龄晋升,避免过早或过晚晋升,从而平衡 Young GC 和 Full GC 的频率与耗时。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


