






在oracle 11g rac环境中实现滚动应用psu补丁,核心做法是严格遵循“单节点维护、集群并行运行”的原则,通过依次关闭并升级每个节点的数据库实例和gi栈,确保业务流量始终由未受影响的节点承载。具体操作需先执行precheck脚本验证环境兼容性,随后按顺序对每个节点进行opatch更新、rdbms二进制文件替换及sql脚本执行,最后重启该节点服务并确认状态正常后再切换至下一节点。

如何验证当前RAC环境是否满足滚动打补丁条件
验证环境是否支持滚动打补丁,主要依赖OPatch工具自带的`prereq`检查功能以及Oracle提供的`validate`命令,重点确认操作系统版本、现有补丁冲突情况以及集群软件(GI)与数据库软件(RDBMS)的版本匹配度。在执行任何实际更改前,必须确保所有节点的`oraInventory`一致,且没有处于挂起或失败状态的先前补丁会话,这是保障后续步骤不中断业务的前提。
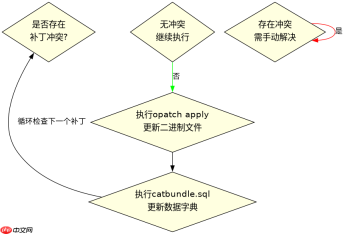
opatch prereq CheckConflictAgainstOHWithDetail -phBaseDir /path/to/psu_patch
opatch auto /path/to/psu_patch -ocmrf /path/to/response_file.xml
上述命令中,`CheckConflictAgainstOHWithDetail`用于扫描指定补丁目录下的文件是否与当前Oracle Home中的文件发生冲突,若输出中包含`Conflict check failed`则说明存在无法自动解决的冲突,需手动处理。而`opatch auto`则是Oracle推荐的自动化滚动补丁工具,它会自动识别RAC节点列表,按顺序在每个节点上执行二进制替换和SQL升级,并通过`-ocmrf`参数调用预生成的OCM响应文件以跳过交互式输入,从而实现无人值守的滚动升级流程。
如何在单个节点升级过程中保持其他节点业务在线
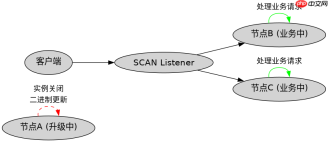
在单个节点进行PSU升级时,保持其他节点业务在线的关键在于正确管理监听器(Listener)和TNS配置,确保客户端连接请求被负载均衡器或SCAN IP正确路由到健康节点。升级期间,目标节点上的数据库实例会被关闭,但该节点所在的服务器资源(如VIP、GSD等)在GI层面仍可能被保留或短暂迁移,需确保网络层面无单点故障,同时避免在该节点上进行任何可能影响共享存储元数据的操作。

# 在目标节点上执行以下操作序列
srvctl stop database -d MYDB -o immediate
# 停止后,执行OPatch apply
opatch apply /path/to/psu_patch
# 执行SQL升级脚本
sqlplus / as sysdba
@catbundle.sql psu apply
@utlrp.sql
# 重启数据库实例
srvctl start database -d MYDB
在上述代码片段中,`srvctl stop database`命令用于优雅地关闭指定数据库的所有实例,`-o immediate`选项确保事务回滚并快速断开连接,此时其他节点的实例仍在运行并处理业务请求。接着,`opatch apply`仅修改当前节点的Oracle二进制文件,不涉及共享数据文件,因此不会影响其他节点。随后执行的`catbundle.sql`和`utlrp.sql`是PSU补丁必需的SQL脚本,用于更新数据字典视图和重新编译无效对象,这些操作仅在本地实例上进行。最后,`srvctl start database`重新启动该节点实例,一旦实例上线,SCAN监听器会立即将其加入可用服务列表,业务流量将逐步恢复至该节点,整个过程对其他节点完全透明。
如果某个节点升级后出现实例启动失败应如何处理
如果某个节点在PSU升级后出现实例启动失败,应立即回滚该节点的OPatch更改并恢复原有二进制文件,同时检查alert日志和OPatch日志以确定失败原因,常见原因包括权限错误、依赖库缺失或SQL脚本执行异常。在处理此问题时,必须确保集群中至少有一个节点正常运行以维持业务连续性,然后针对故障节点进行隔离修复,修复完成后再次尝试滚动升级,若问题持续则需考虑全停机维护方案。


