






使用 protobuf 提升 java 对象序列化性能的核心做法是:将传统的 pojo 替换为 protobuf 生成的 message 类,利用其基于二进制协议(wire format)和零拷贝机制的特性,减少 cpu 计算开销与内存分配。具体实现时,需定义 .proto 文件并生成 java 代码,在业务逻辑中直接调用生成的 builder 构建对象,并通过 tobytearray() 或 writeto() 方法输出字节流。相比 json 或传统 java 原生序列化,protobuf 能显著降低序列化后的体积并提升编解码速度。

如何定义 Proto 结构并生成 Java 类
首先需要编写 .proto 描述文件来定义数据结构,然后使用 Protobuf 编译器将其转换为 Java 源码。这一步是基础,决定了后续序列化的字段布局和类型映射。开发者只需关注消息字段的命名、类型及标签号,无需手动处理复杂的映射逻辑。
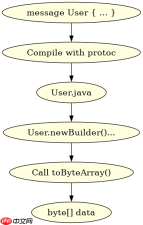
message User {
  int32 id = 1;
  string name = 2;
  bool active = 3;
}

// 编译命令示例
// protoc --java_out=./src main.proto
上述 User 消息定义了三个字段。编译后,Protobuf 会生成一个包含内部静态类 Builder 的 User 类。开发者通过链式调用 setId()、setName() 等方法构建对象,最终调用 build() 获得不可变的 User 实例。这种构建方式避免了反射带来的性能损耗,且生成的类结构紧凑。
序列化与反序列化的实际执行流程
在实际代码中,序列化过程主要涉及将对象写入字节数组或输出流,而反序列化则是从字节数据重建对象。Protobuf 提供了多种 API 来满足不同的 I/O 场景需求,核心在于其高效的二进制编码策略。


// 序列化示例
User user = User.newBuilder()
    .setId(1001)
    .setName("Alice")
    .setActive(true)
    .build();

byte[] data = user.toByteArray();

// 反序列化示例
User parsedUser = User.parseFrom(data);
在序列化阶段,toByteArray() 方法会将对象的所有非默认值字段按照 Tag-Length-Value (TLV) 格式编码为字节数组。对于整数类型,它采用 Varint 编码,小数值占用更少字节。在反序列化阶段,parseFrom() 方法解析字节流,根据 Tag 定位字段并赋值。由于 Protobuf 是强类型的,解析器可以直接映射到对应的 Java 基本类型或对象,无需像 JSON 那样进行字符串解析和类型推断,从而大幅提升了处理速度。
Protobuf 在处理空值或缺省字段时的行为差异
当程序中存在未设置值的字段时,Protobuf 的行为与传统对象不同。默认情况下,Protobuf 不会序列化具有“默认值”的字段,这有助于进一步压缩数据体积。例如,如果 id 字段未被显式设置,它在序列化后的字节流中将不存在,反序列化时会恢复为 Java 的默认值(如 0)。这种行为在高频网络传输中能显著减少带宽消耗,但开发者需注意在业务逻辑中区分“未设置”与“显式设置为默认值”的情况,必要时可使用 optional 修饰符(Proto3 中已移除,需用包装类型或 Oneof 处理)或自定义逻辑来标记状态。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



