






部署hy4 flash应使用官方提供的vllm专用镜像,并按完整权重、engram主机内存及kv缓存规划资源。当前配方面向nvidia hopper或blackwell数据中心gpu,不支持直接套用普通vllm正式版安装包。下例按官方8卡配置启动fp8模型,并将接口绑定到本机回环地址;8卡示例是配方配置,不是对所有显卡型号的容量保证。
准备支持的GPU与容器环境
先确认GPU型号、驱动和NVIDIA容器运行环境可用。配方列出H100/H200及B200、GB200、B300、GB300等平台,并说明AMD Instinct ROCm支持尚未提供。除GPU显存外,Engram卸载还需要主机内存;12B活跃参数不代表只需装入12B权重。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
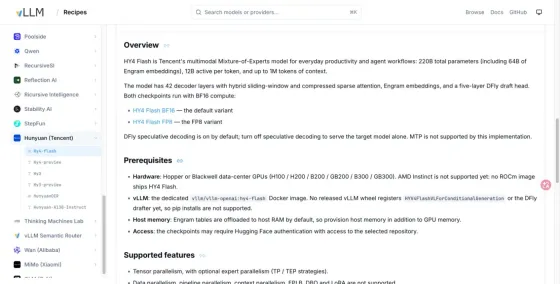
vLLM官方配方列出的适用硬件和部署前提。
从较短上下文启动FP8服务
在具备相应资源的Linux主机执行以下命令。权重缓存在Hugging Face缓存目录;首次下载需要额外磁盘空间和时间。将上下文设为8192、并发序列设为4,先确认服务能稳定启动,再按实际资源提高配置。
docker run --gpus all --ipc=host \
  -p 127.0.0.1:8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:hy4-flash tencent/Hy4-flash-FP8 \
  --tensor-parallel-size 8 \
  --speculative-config '{"num_speculative_tokens":5,"method":"dfly"}' \
  --attention-backend FLASHMLA_SPARSE \
  --tool-call-parser hy_v4 --reasoning-parser hy_v4 \
  --enable-auto-tool-choice --served-model-name hy4-flash \
  --max-model-len 8192 --max-num-seqs 4 --port 8000
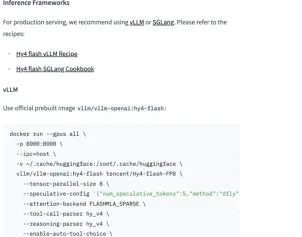
官方模型卡的专用镜像示例;完整启动参数以上述文字命令为准。
验证模型列表和一次短请求
curl -sS http://127.0.0.1:8000/v1/models
curl -sS http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"hy4-flash","messages":[{"role":"user","content":"用一句话介绍自己"}],"max_tokens":128,"temperature":0.9,"top_p":1.0,"chat_template_kwargs":{"reasoning_effort":"no_think"}}'
模型列表中的名称应包含启动时设置的hy4-flash,聊天响应应有choices及message.content。no_think用于本例的短文本验证;需要推理时按模型卡选择对应思考设置,不把所有推理输出强行当成正文。
按失败阶段排查
下载失败先检查模型访问和缓存空间;仓库要求认证时,在宿主机环境配置有权限的HF_TOKEN,再为Docker追加--env HF_TOKEN以继承,避免将令牌值写入命令记录;加载阶段内存不足,应核对权重、主机RAM、并行度及缓存预算;启动参数不识别则核对是否用了hy4-flash专用镜像。服务已启动但请求模型不存在时,检查served-model-name与请求字段是否一致。
100万Token是模型支持上限,不等于这份8192上下文配置已经开放该容量。需要多模态或提高并发时,按配方单独计算资源;不要直接暴露未配置鉴权的接口到公网。













