






gpt-6.2的多轮集成应尽量保持已经发送的历史前缀不变,把新指令、工具结果和补充要求追加在后面。官方说明,改写旧开发者消息、缩短过去的工具输出或重排历史,都可能降低缓存复用,并使相应历史之后的推理项被移除;更稳妥的省token位置是在内容第一次进入上下文之前。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
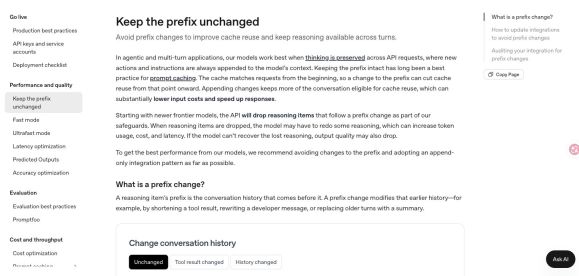
官方文档区分缓存复用和历史推理保留。
先把确定性长输出整理成可追溯材料
例如,一次工具返回几千行列表时,可以先把完整结果落文件,再只向模型提供相关条目、文件定位和必要限制。后续需要细节时再追加相应段落。不要在该长输出已经被模型使用后,把历史中的原项原地替换成摘要;这会改变前缀。压缩也不能省去事实依据、错误信息或完成判断所需的关键数据。
多轮输入采用追加模式
安装或更新官方Python SDK,并在环境中设置OPENAI_API_KEY。下面展示显式维护输入列表的模式;示例仅说明上下文组织,不代表短对话一定触发缓存。
from openai import OpenAI

client = OpenAI()
history = [
    {"role": "developer", "content": "审核API说明,保留版本条件;不编造缺失参数。"},
    {"role": "user", "content": "先列出这份接口说明需要核对的条件。"},
]

first = client.responses.create(
    model="gpt-6.2-sol", input=history,
    reasoning={"effort": "medium"},
)
# 保留原顺序及完整响应项;不要重写已经发送过的历史。
history.extend(first.output)
history.append({"role": "user", "content": "新增要求:把认证方式单独列出。"})

second = client.responses.create(
    model="gpt-6.2-sol", input=history,
    reasoning={"effort": "medium"},
)
print(second.output_text)
print("input_tokens:", second.usage.input_tokens)
print("cached_tokens:", second.usage.input_tokens_details.cached_tokens)
print("output_tokens:", second.usage.output_tokens)
first.output中可能有消息、推理及工具调用,应按原顺序保留。实际应用遇到工具调用时,还要执行授权工具并追加对应结果,不能把工具调用直接视为最终文本。更换用户或应用身份、降低模型能力或改变历史,都可能受到额外的推理保留限制。

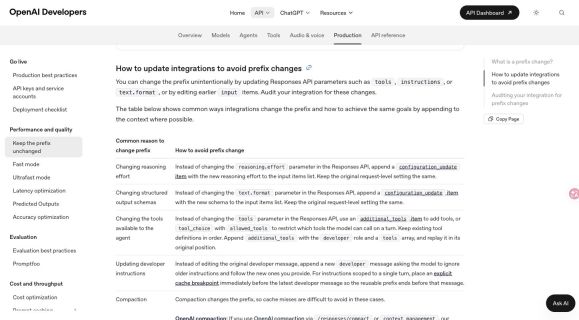
官方对推理配置、结构化格式、工具及开发者消息的变更处理表。
修改配置与压缩都有单独路径
官方建议对支持的配置使用追加项,例如configuration_update;增加工具可用additional_tools,并保持已有工具定义的顺序。不能自行猜测这些项的JSON结构,应按对应接口参考实现。使用OpenAI的/responses/compact或context_management时,其保留后续推理的处理与自制摘要不同;自制压缩仍需接受前缀变化带来的取舍。
用实际用量验证,不能承诺固定节省率
先比较input_tokens、cached_tokens和output_tokens,再看完成质量、重试和延迟。Prompt Cache Diagnostics可与前次响应对比缓存差异;input_transformations可显示哪些输入推理项被移除及原因。诊断按尽力方式报告首个差异,不能据此证明模型实际复用了全部推理,也不能把一次缓存命中外推为固定的总Token降幅。


