openai发布gpt-6.2 astra和gpt-6.2 sol两款模型。astra面向复杂专业项目,sol侧重日常工作与规模化智能体任务;两者都接受文本、图像输入并输出文本。官方此次强调长流程执行、代码修改和计算机操作能力,并公布了不同任务下的成绩与成本对照。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
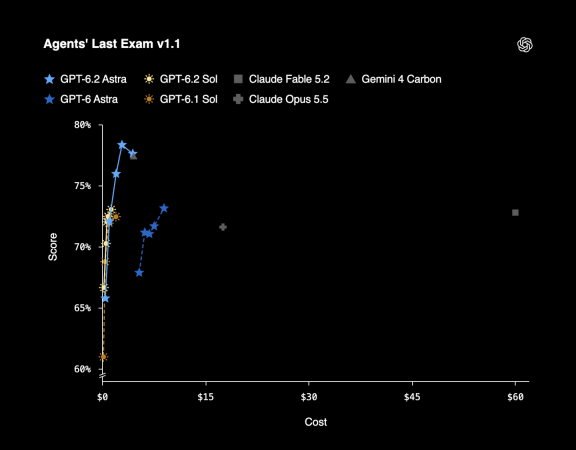
OpenAI官方评测图:横轴是每项任务成本,纵轴是得分。
长流程评测的提升有特定口径
在Agents’ Last Exam v1.1中,GPT-6.2 Astra的得分较GPT-6 Astra高5.2个百分点,单项任务成本不到后者三分之一;相较Claude Fable 5.2,得分高5.5个百分点,成本约为其5%。这组结果来自特定任务、执行框架和模型配置,并非API每百万Token统一降价到原来的5%。官方还注明,对照榜中Fable 5.2的结果不包含九项使用备用模型的任务。
Sol强调常见代码任务中的效率
在Cognition的FrontierCode 2.0测试中,GPT-6.2 Sol与Astra的得分相差不到0.5分,任务成本约为Astra的五分之一,两者均使用Max推理强度。该测试关注真实代码库修改是否符合维护者的合并标准,不能据此认定Sol在全部研究或专业任务上与Astra等同。

记录结构化的Claude Code轨迹、影子git diff,并在代理行为需要法医级调试而非临时转录审查时回放分支。
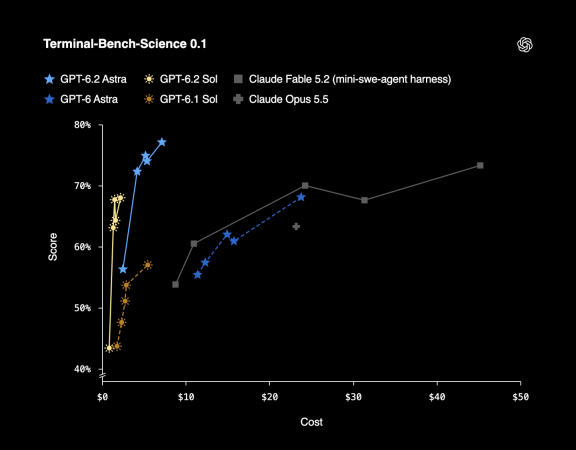
官方科研工作流基准;不同基准的任务与成本口径各自独立。
接入仍须核对模型与接口能力
两款模型的官方API文档均列出105万Token上下文、最多922000个输入Token和128000个输出Token,并明确不接受reasoning.effort设为none的请求。图像属于输入能力;需要生成图片、语音或操作计算机时,还要按相应工具与接口配置,不能把文本模型的输入输出规格理解为已包含所有媒体端点。