






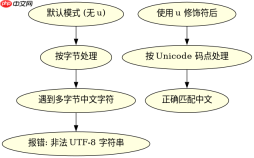
php正则表达式匹配中文失败通常是因为未使用 u 修饰符,导致正则引擎将多字节的 utf-8 中文字符误判为非法字节序列而报错或匹配失败。解决方法是在正则表达式的末尾添加 u 修饰符,强制 pcre 引擎以 utf-8 模式处理字符串,从而正确识别 unicode 字符。

为什么默认模式下中文匹配会报错?
在默认模式下,PCRE 引擎按字节流处理字符串。一个中文字符在 UTF-8 编码中占三个字节,这些字节的值通常大于 127。如果正则表达式中包含非 ASCII 字符(如中文),或者目标字符串包含非 ASCII 字符,引擎会认为遇到了“非法”字节并抛出警告或返回 false。例如,直接使用 /[一-龥]/ 去匹配一个包含中文的 UTF-8 字符串,如果没有 u 修饰符,PHP 会提示 “Compilation failed: invalid UTF-8 string”。
<?php $pattern = '/[\x{4e00}-\x{9fa5}]/u';
$text = 'Hello 世界';
if (preg_match($pattern, $text)) {
    echo "Match found";
} else {
    echo "No match";
}
?>
上述代码中,[\x{4e00}-\x{9fa5}] 是常用的中文范围正则,但必须配合 u 修饰符才能生效。运行结果为 “Match found”,因为 u 告诉引擎按 Unicode 码点匹配,而不是按字节。

使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
如何正确编写支持中文的正则表达式?
要正确匹配中文,除了使用 u 修饰符外,还需要选择合适的字符范围。常见的做法是使用 Unicode 属性 \p{Han} 或者明确的码点范围 \x{4e00}-\x{9fa5}。\p{Han} 能覆盖更广泛的汉字,包括繁体和异体字,而 \x{4e00}-\x{9fa5} 仅覆盖基本多文种平面中的常用汉字。在实际开发中,推荐使用 \p{Han} 以获得更好的兼容性。

<?php $pattern = '/\p{Han}/u';
$text = 'Hello 世界 Hello';
$matches = [];
preg_match_all($pattern, $text, $matches);
print_r($matches[0]);
?>
运行上述代码,输出为:
Array
(
[0] => 世
[1] => 界
)
这证明了 \p{Han} 配合 u 修饰符可以准确提取所有中文字符。
如果输入字符串不是 UTF-8 编码怎么办?
如果输入的字符串不是 UTF-8 编码(例如 GBK 或 ISO-8859-1),即使使用 u 修饰符也会匹配失败。此时需要先使用 mb_convert_encoding() 或 iconv() 将字符串转换为 UTF-8 编码,然后再进行正则匹配。例如,对于 GBK 编码的字符串,可以先调用 $utf8Text = mb_convert_encoding($gbkText, 'UTF-8', 'GBK');,然后再应用带有 u 修饰符的正则表达式。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





