






sql视图中的count聚合在大数据量下超时,通常是因为查询优化器无法利用索引快速统计行数,而是被迫对底层表进行全表扫描或复杂的中间结果集计算。要解决这个问题,最直接的办法是为参与聚合的列建立合适的索引,或者使用物化视图来预计算并缓存结果,从而避免每次查询都执行昂贵的实时聚合操作。
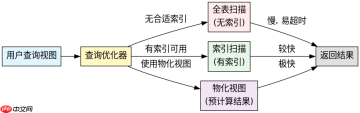
为什么普通视图COUNT会触发全表扫描
当视图定义包含COUNT(*)或基于非索引列的聚合时,数据库引擎必须读取实际数据页来计算行数。如果表没有聚簇索引或覆盖索引,这种操作就是I/O密集型的,导致超时。
-- 假设有一个大表 orders
CREATE TABLE orders (
    id INT PRIMARY KEY,
    status VARCHAR(50),
    created_at TIMESTAMP
);

-- 创建普通视图
CREATE VIEW v_order_count AS
SELECT COUNT(*) as total_count
FROM orders
WHERE status = 'active';

-- 查询视图
SELECT * FROM v_order_count;
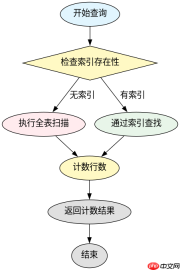
在上述代码中,查询v_order_count时,数据库需要扫描orders表中所有满足status = 'active'的行。如果没有针对status列的索引,这将是一个全表扫描过程。对于数百万行数据,这种实时计算极易超时。
如何通过索引优化加速COUNT聚合
为聚合条件列添加索引可以显著减少扫描范围。如果查询只涉及索引列,数据库可能只需遍历索引树即可得到计数,无需访问数据页。
-- 为 status 列添加索引
CREATE INDEX idx_status ON orders (status);

-- 再次查询视图
SELECT * FROM v_order_count;
添加索引后,数据库可以利用idx_status快速定位到status = 'active'的记录数量。在某些数据库(如MySQL InnoDB)中,如果查询是COUNT(*)且没有WHERE子句,聚簇索引的主键扫描会比二级索引更快。但在有过滤条件的情况下,二级索引能大幅减少I/O开销。
物化视图如何解决大数据量下的性能瓶颈
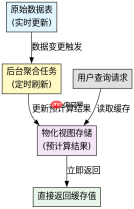
对于极大数据量,即使有索引,实时聚合仍有延迟。物化视图(Materialized View)将聚合结果持久化存储,查询时直接读取预计算的值,彻底消除实时计算开销。
-- 创建物化视图(语法因数据库而异,此处以通用概念为例)
CREATE MATERIALIZED VIEW mv_order_count AS
SELECT COUNT(*) as total_count
FROM orders
WHERE status = 'active';

-- 刷新物化视图(定期执行)
REFRESH MATERIALIZED VIEW mv_order_count;

-- 查询物化视图
SELECT * FROM mv_order_count;
物化视图将COUNT的结果存储在单独的物理结构中。查询mv_order_count时,数据库直接返回缓存的值,时间复杂度为O(1)。虽然需要定期刷新以保持数据一致性,但这避免了每次查询都进行全表扫描,是解决大数据量超时的终极方案。


