






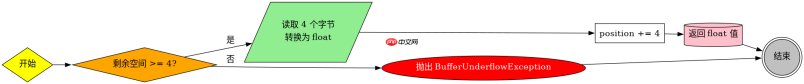
调用 bytebuffer 实例的 getfloat() 方法即可从当前 position 开始读取并自动将指针后移 4 个字节。该方法会尝试将接下来的 4 个字节按照当前字节序(默认为大端)转换为一个 float 值,如果剩余字节不足 4 个则抛出 bufferunderflowexception。
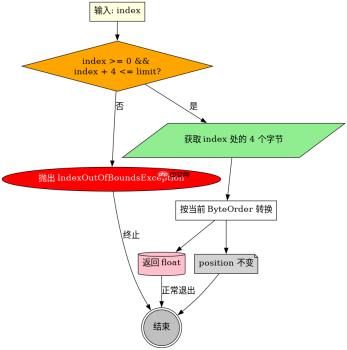
如何指定读取起始位置而不移动指针
使用 getFloat(int index) 方法可以在不改变缓冲区 position 的情况下读取指定索引处的浮点数。这在需要多次查看同一数据或进行非顺序解析时非常有用,读取操作完成后 position 保持不变,但 mark 也不会被更新。

Build Java agent transport gateways with Atmosphere
下载
使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
import java.nio.ByteBuffer;

public class GetFloatExample {
    public static void main(String[] args) {
        // 创建 ByteBuffer 并写入一个 float
        ByteBuffer buffer = ByteBuffer.allocate(8);
        buffer.putFloat(0, 3.14f); // 在索引 0 处写入
        buffer.putFloat(4, 2.71f); // 在索引 4 处写入

        // 使用 getFloat(index) 读取,不改变 position
        System.out.println("Index 0: " + buffer.getFloat(0));
        System.out.println("Index 4: " + buffer.getFloat(4));

        // 此时 position 仍然是 0
        System.out.println("Position: " + buffer.position());
    }
}
字节序对读取结果的影响是什么
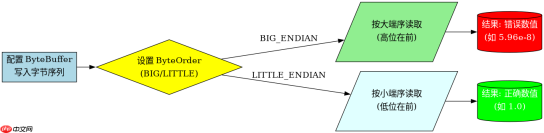
getFloat() 的行为严格依赖于缓冲区的字节序(Byte Order)。默认情况下,ByteBuffer 是大端序(Big-Endian),即高位字节存储在低地址。如果数据是以小端序(Little-Endian)写入的,直接调用 getFloat() 会得到错误的数值。必须通过 order(ByteOrder.LITTLE_ENDIAN) 修改缓冲区的字节序设置,才能正确解析小端数据。
import java.nio.ByteBuffer;
import java.nio.ByteOrder;

public class ByteOrderExample {
    public static void main(String[] args) {
        ByteBuffer buffer = ByteBuffer.allocate(4);

        // 假设原始数据是小端序存储的 1.0f
        // 1.0f 的二进制表示为 0x3F800000
        // 小端存储:00 00 80 3F
        byte[] littleEndianBytes = {(byte)0x00, (byte)0x00, (byte)0x80, (byte)0x3F};
        buffer.put(littleEndianBytes);

        buffer.flip();

        // 错误读取:默认大端序
        float wrongValue = buffer.getFloat(); // 结果为 0.0000000596...
        System.out.println("Wrong (Big-Endian): " + wrongValue);

        // 重置缓冲区
        buffer.position(0);

        // 正确读取:设置为小端序
        buffer.order(ByteOrder.LITTLE_ENDIAN);
        float correctValue = buffer.getFloat(); // 结果为 1.0
        System.out.println("Correct (Little-Endian): " + correctValue);
    }
}
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


