






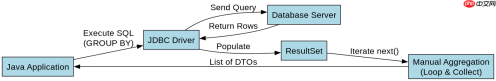
java jdbc 处理分组查询时,核心做法是执行带有 group by 子句的 sql 语句,并在 java 代码中通过 resultset 遍历结果集。由于 jdbc 标准 api 不直接支持将结果自动映射为嵌套的 map 或 list 结构,开发者需要手动编写逻辑来聚合数据,通常是将相同分组键的数据收集到同一个对象或集合中。
如何按部门 ID 统计员工数量并获取列表
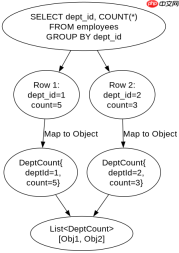
针对按部门 ID 统计员工数量的需求,可以直接使用 COUNT(*) 配合 GROUP BY 进行查询。在 Java 实现中,需要定义一个 DTO 类来存储部门 ID 和对应的计数值,然后在循环中逐行读取 ResultSet 并将结果添加到列表中。
import java.sql.*;
import java.util.ArrayList;
import java.util.List;

public class DeptCountQuery {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        // 实际使用时请替换为真实的用户名和密码
        String user = "root";
        String password = "password";

        String sql = "SELECT dept_id, COUNT(*) as emp_count FROM employees GROUP BY dept_id";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql);
             ResultSet rs = pstmt.executeQuery()) {

            List<deptcount> results = new ArrayList();
            while (rs.next()) {
                int deptId = rs.getInt("dept_id");
                long count = rs.getLong("emp_count");
                results.add(new DeptCount(deptId, count));
            }
            System.out.println(results);
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    static class DeptCount {
        int deptId;
        long count;
        DeptCount(int d, long c) { deptId = d; count = c; }
        @Override public String toString() { return "DeptCount{deptId=" + deptId + ", count=" + count + "}"; }
    }
}</deptcount>
上述代码执行后,预期输出为一个包含多个 DeptCount 对象的列表,每个对象代表一个部门的统计结果。例如,如果数据库中有两个部门,ID 分别为 1 和 2,且分别有 5 和 3 名员工,则输出可能类似:[DeptCount{deptId=1, count=5}, DeptCount{deptId=2, count=3}]。这种手动遍历的方式确保了内存中的数据结构与数据库返回的行结构一一对应。
如何处理分组后的多字段聚合(如平均薪资)
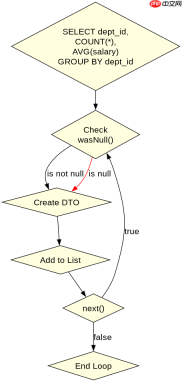
当分组查询需要同时计算多个聚合指标,例如既统计人数又计算平均薪资时,SQL 语句需包含多个聚合函数。Java 端的处理方式与单字段统计一致,只需在 ResultSet 中提取额外的列即可。关键在于确保提取的列名与 SQL 中的别名或实际列名完全匹配。

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
import java.sql.*;
import java.util.ArrayList;
import java.util.List;

public class DeptStatsQuery {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        String sql = "SELECT dept_id, COUNT(*) as emp_count, AVG(salary) as avg_salary FROM employees GROUP BY dept_id";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql);
             ResultSet rs = pstmt.executeQuery()) {

            List<deptstats> results = new ArrayList();
            while (rs.next()) {
                int deptId = rs.getInt("dept_id");
                long count = rs.getLong("emp_count");
                double avgSalary = rs.getDouble("avg_salary");
                results.add(new DeptStats(deptId, count, avgSalary));
            }
            System.out.println(results);
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    static class DeptStats {
        int deptId;
        long count;
        double avgSalary;
        DeptStats(int d, long c, double a) { deptId = d; count = c; avgSalary = a; }
        @Override public String toString() { return "DeptStats{deptId=" + deptId + ", count=" + count + ", avgSalary=" + avgSalary + "}"; }
    }
}</deptstats>
运行该程序,预期输出将包含每个部门的 ID、员工总数以及平均薪资。例如:[DeptStats{deptId=1, count=5, avgSalary=5000.0}, DeptStats{deptId=2, count=3, avgSalary=6000.0}]。这里需要注意,如果某部门没有员工(虽然 GROUP BY 通常只返回有数据的组),或者 AVG 结果为 null,rs.getDouble 可能会返回 0.0 或触发异常,具体取决于驱动实现,通常建议在 SQL 中使用 COALESCE 或在 Java 中检查 rs.wasNull()。
当分组字段存在 NULL 值时 JDBC 如何处理
在分组查询中,如果 GROUP BY 的字段包含 NULL 值,JDBC 会将所有 NULL 值视为同一个分组键,即它们会被归为一组。这意味着在 ResultSet 中,你会看到一行或多行记录,其分组字段的值为 null。开发者需要在 Java 代码中显式处理这种情况,避免空指针异常。
import java.sql.*;
import java.util.ArrayList;
import java.util.List;

public class NullGroupQuery {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        // 假设 employees 表中 dept_id 可能有 NULL
        String sql = "SELECT dept_id, COUNT(*) as emp_count FROM employees GROUP BY dept_id";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql);
             ResultSet rs = pstmt.executeQuery()) {

            List<deptcount> results = new ArrayList();
            while (rs.next()) {
                // 注意:getInt 对于 NULL 会返回 0,需检查 wasNull
                if (rs.wasNull()) {
                    results.add(new DeptCount(null, rs.getLong("emp_count")));
                } else {
                    results.add(new DeptCount(rs.getInt("dept_id"), rs.getLong("emp_count")));
                }
            }
            System.out.println(results);
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    static class DeptCount {
        Integer deptId; // 使用包装类以支持 null
        long count;
        DeptCount(Integer d, long c) { deptId = d; count = c; }
        @Override public String toString() { return "DeptCount{deptId=" + deptId + ", count=" + count + "}"; }
    }
}</deptcount>
此代码的预期输出会包含一个 deptId 为 null 的对象,例如:[DeptCount{deptId=null, count=2}, DeptCount{deptId=1, count=5}]。这表明有两个员工的部门 ID 为空,被单独分在一组。使用 Integer 而非 int 是为了能够正确表示 NULL 状态,而 rs.wasNull() 是判断当前行对应列是否为 SQL NULL 的标准方法。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


