解决swoole协程中闭包引用导致的内存泄漏,核心做法是切断协程上下文与外部大对象之间的强引用循环。具体而言,在闭包内部使用$this或全局变量时,需确保协程结束后不再持有对大型数组、数据库连接或http客户端的引用;若必须跨协程传递数据,应通过channel或共享内存进行序列化拷贝,而非直接传递对象指针。

为什么闭包会捕获协程上下文导致泄漏?
当在Swoole协程中使用匿名函数(闭包)时,PHP引擎会自动将当前作用域内的变量“捕获”并绑定到闭包对象上。如果这些变量包含大型数据结构(如几MB的JSON解析结果或数据库查询集),且该闭包被注册为回调(例如异步IO完成后的处理),只要协程未完全退出或回调未被执行,这些大对象就会一直驻留在内存中。更严重的是,如果闭包内部又引用了包含该数据的对象,或者使用了$this指向一个长生命周期的服务类,就会形成引用环,导致GC无法回收。
<?php use Swoole\Coroutine;
use Swoole\Coroutine\Channel;

class DataProcessor {
    private $data = [];

    public function processLargeData(array $input) {
        // 模拟大数据量
        $largePayload = str_repeat('x', 1024 * 1024); // 1MB

        Coroutine::create(function () use ($largePayload) {
            // 闭包捕获了 $largePayload
            // 即使协程结束,如果外部仍有引用或GC未触发,可能滞留
            echo "Processing: " . strlen($largePayload) . " bytes\n";
            unset($largePayload); // 手动释放局部引用
        });
    }
}

$processor = new DataProcessor();
$processor->processLargeData([]);
// 注意:此处仅演示结构,实际泄漏常发生在异步回调链中
上述代码展示了基本场景。在实际Swoole应用中,泄漏往往发生在异步任务队列或HTTP请求生命周期内。关键在于理解use关键字带来的隐式引用。如果传入的是对象,引用计数会增加;如果是资源(如文件句柄),则必须显式关闭。对于大型数组,建议在闭包执行完毕后立即unset相关变量,或者重构代码避免在闭包中捕获不必要的大对象。
如何通过Channel解耦协程间的数据传递?
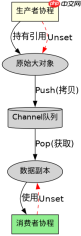
为了避免闭包直接引用外部复杂对象,推荐使用Swoole的Channel作为协程间通信的桥梁。Channel基于无锁队列实现,发送数据时会进行值拷贝(对于标量和数组)或序列化(对于对象)。这样,原始协程可以立即释放对大对象的引用,而接收协程通过Channel获取独立副本。这种方法彻底切断了源对象与目标协程闭包之间的直接引用链,有效防止因引用计数不降导致的内存泄漏。

Swoole 6.1.1 是一个专为 PHP 设计的高性能事件驱动并发网络引擎。作为稳定版,它修复了编译时对 zlib 依赖的缺失及 curl 模块的内存安全风险。该版本支持协程、多线程与多进程架构,内置 TCP/HTTP/WebSocket 服务器,能够显著提升 PHP 在微服务、实时通信等场景下的执行效率与并发能力。
<?php use Swoole\Coroutine;
use Swoole\Coroutine\Channel;

Coroutine::set(['hook_flags' => SWOOLE_HOOK_ALL]);

Coroutine::create(function () {
    $chan = new Channel(100);
    $largeData = str_repeat('y', 1024 * 512); // 512KB

    // 生产者:放入Channel后,可立即unset
    $chan->push($largeData);
    unset($largeData); // 关键:切断引用

    // 消费者:从Channel获取独立副本
    Coroutine::create(function () use ($chan) {
        $data = $chan->pop();
        if ($data !== false) {
            echo "Received data size: " . strlen($data) . "\n";
            unset($data); // 消费后释放
        }
    });
});
在这个示例中,Channel充当了缓冲区。生产者协程将数据推入通道后,立即调用unset销毁本地变量,此时引用计数下降。消费者协程通过pop()获取数据,获得的是通道的副本。这种模式特别适用于高并发下的日志收集、任务分发等场景,能显著降低峰值内存占用。需要注意的是,对于超大对象,频繁序列化/反序列化可能有性能开销,此时可考虑使用共享内存或内存映射文件。
在HTTP服务器中如何清理Request和Response对象?
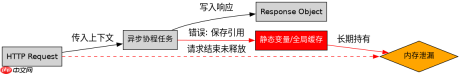
在Swoole HTTP服务器中,每个请求都会创建新的Request和Response对象。如果在闭包回调中错误地保存了这些对象的引用(例如存入静态属性或全局容器),它们将在整个进程生命周期内无法释放,导致内存无限增长。正确的做法是确保所有回调都是临时的,且在请求结束时自动销毁。若需在多个协程间共享状态,应使用Swoole\Runtime::enableCoroutine()配合独立的存储机制,而非依赖闭包捕获。
<?php use Swoole\Http\Server;
use Swoole\Http\Request;
use Swoole\Http\Response;

$server = new Server("127.0.0.1", 9501);

$server->on("request", function (Request $request, Response $response) {
    // 错误示范:将$request存入静态变量
    // self::$req = $request;

    // 正确做法:仅在当前协程上下文中使用
    Coroutine::create(function () use ($request, $response) {
        // 模拟异步DB查询
        $result = queryDb($request->get['id']);
        $response->end(json_encode($result));
        // 请求结束时,$request和$response自动析构
    });
});

$server->start();
此段代码强调了在HTTP回调中避免持久化引用的重要性。Swoole的请求处理模型是基于协程的,每次请求都是一个独立的协程栈。一旦回调执行完毕,栈帧弹出,局部变量自然释放。任何试图将这些变量提升到更高作用域的行为,都会破坏这一自动清理机制,引发泄漏。因此,保持代码的局部性,是预防此类泄漏的最有效手段。