






在 docker swarm 中服务版本回滚失败,通常是因为当前运行的容器状态异常(如未健康检查通过)或配置冲突导致调度器无法将旧版本镜像重新分配给节点。解决此问题的核心做法是:先使用 docker service inspect 查看服务当前的详细状态和错误日志,确认是否因健康检查失败或资源不足导致部署停滞;若确认为状态卡死,可尝试强制更新服务配置以触发重新调度,或直接删除并重建该服务来恢复至指定版本。

如何查看回滚失败的具体原因
要确定回滚为何失败,必须检查服务的运行状态和任务分布。使用 docker service ps 命令可以列出该服务所有任务的当前状态。如果回滚操作后,部分任务显示为 Failed 或 Rejected,则说明调度器在尝试启动旧版本容器时遇到了阻碍。常见的阻碍包括:目标节点磁盘空间不足、端口冲突、或者旧版本镜像拉取失败。此外,如果服务配置了健康检查,而旧版本容器启动后未能通过健康检查,Swarm 也会标记任务为失败,从而阻止回滚完成。
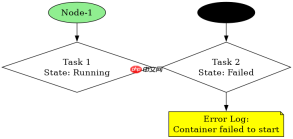
docker service ps my_app
NAME                IMAGE               NODE                DESIRED STATE       CURRENT STATE           ERROR               PORTS
my_app.1            my_app:v1.0         node-1              Running             Running 5 seconds ago
my_app.2            my_app:v1.0         node-2              Failed              Failed 10 seconds ago   "container failed to start"
在上述输出中,my_app.2 任务处于 Failed 状态,且错误信息提示容器启动失败。这直接指出了回滚失败的具体节点和原因。此时,应进一步使用 docker service logs --raw --tail 20 my_app 查看该服务的标准输出和错误日志,以获取更详细的崩溃信息,例如缺少环境变量或依赖库缺失等。

如何通过强制更新触发重新调度
当服务处于僵持状态,且确认问题并非由镜像本身引起时,可以通过修改服务的一个无关配置项来触发“滚动更新”,从而强制 Swarm 重新调度所有任务。这种方法比直接删除服务更安全,因为它能保持服务的连续性。具体做法是使用 docker service update 命令,添加一个无实际影响的标志,例如 --force 或修改 --env 中的一个临时变量。
docker service update --force my_app
# 或者
docker service update --env-add ROLLBACK_TRIGGER=true my_app
docker service update --env-rm ROLLBACK_TRIGGER=true my_app
执行 --force 参数会立即停止所有现有容器并重新启动它们,这会绕过某些缓存状态,促使调度器重新评估每个节点的可用性并尝试部署旧版本镜像。如果回滚是因为之前的更新引入了不兼容的配置,这种强制刷新往往能解决问题。需要注意的是,如果旧版本镜像确实存在缺陷,强制更新只会重复失败,因此务必先通过日志确认镜像本身的可用性。
基于服务状态卡死时的具体处理步骤
如果上述方法均无效,且服务长时间处于 Shutdown 或 Rerun 状态,可能需要手动干预。首先,确保集群中有足够的可用资源。可以使用 docker node ls 检查节点状态,确保没有节点被标记为 Down。其次,清理残留的容器和网络。虽然 Swarm 会自动管理,但在极端情况下,手动清理可能有助于释放锁定的资源。最后,作为最后手段,可以删除服务并重新创建。使用 docker service rm my_app 删除服务,然后使用 docker service create 配合指定的镜像版本重新创建。这种方式能彻底重置服务的状态机,确保从干净的基线开始部署。


