






postgresql 14中实现带条件的count distinct聚合,最直接且高效的方法是使用 count(distinct ...) 结合 case 表达式。这种写法允许你在聚合时仅对满足特定条件的行进行去重计数,无需预先过滤数据或进行复杂的子查询连接。

CASE 表达式在 COUNT DISTINCT 中的具体用法是什么?
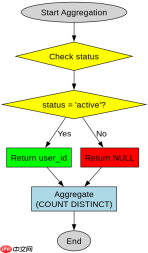
通过 CASE 表达式,你可以指定哪些行参与去重计数,哪些行被忽略(返回 NULL)。这是处理条件去重的标准 SQL 模式。
SELECT
    category,
    COUNT(DISTINCT CASE WHEN status = 'active' THEN user_id END) AS active_user_count,
    COUNT(DISTINCT CASE WHEN status = 'inactive' THEN user_id END) AS inactive_user_count
FROM
    orders
GROUP BY
    category;
在上述代码中,当 status 不等于 'active' 时,CASE 返回 NULL。COUNT 函数会自动忽略 NULL 值,因此只有状态为 'active' 的 user_id 会被纳入去重统计。这种方法逻辑清晰,且能充分利用 PostgreSQL 的哈希聚合优化。
如果条件涉及多列组合,如何确保去重准确性?
当需要基于多个字段的组合进行去重时,只需将多个字段放入 CASE 表达式的返回值中,并使用元组语法 (col1, col2)。PostgreSQL 支持对元组进行去重,这确保了只有当所有指定字段的组合完全相同时,才被视为重复项。

SELECT
    region,
    COUNT(DISTINCT CASE
        WHEN amount > 100 THEN (customer_id, order_date)
    END) AS high_value_orders
FROM
    transactions
GROUP BY
    region;
这里,COUNT(DISTINCT ...) 会对 (customer_id, order_date) 的组合进行去重。这意味着同一个客户在同一天下的多笔大额订单只会被计数一次。这种机制在处理复杂业务逻辑时非常有用,例如计算每个区域的高价值独立交易次数。注意,如果 amount 不大于 100,则返回 NULL,不参与计数。
使用 CASE 时,如何处理 NULL 值以避免意外计数?
在使用 CASE 进行条件计数时,必须明确处理 NULL 值。如果 CASE 表达式未覆盖所有情况且未显式返回 ELSE NULL,默认行为是返回 NULL,这通常符合预期。但如果条件本身可能产生 NULL(例如比较操作),需确保这些 NULL 不会干扰去重逻辑。此外,若希望将 NULL 视为一个独立的去重项,应使用 COALESCE 将其转换为占位符,但通常不建议这样做,因为 COUNT 会忽略 NULL。


