






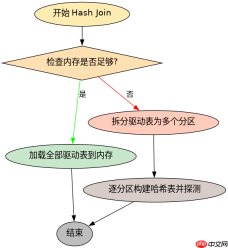
当驱动表(build table)的数据量超过数据库内存中为hash join分配的缓冲区大小时,无法一次性将所有数据加载到内存中构建完整的哈希表。此时数据库引擎会采用“分区”策略,将驱动表根据哈希值拆分为多个较小的子集,并分批次与探测表进行连接,或者在内存不足时降级为nested loop join或sort merge join。
Hash Join的内存分配机制是什么
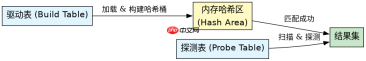
Hash Join的执行依赖于一个固定的内存区域,通常称为Hash Area或Work Memory。在执行阶段,数据库会将驱动表的数据读入该区域,通过哈希函数计算键值的分布,从而构建哈希桶。如果驱动表的行数乘以每行的平均宽度超过了这个限制,就会发生溢出。
SELECT /*+ USE_HASH(a b) */ a.id, b.name
FROM large_table_a a
JOIN small_table_b b ON a.bid = b.id;
在上述SQL中,如果large_table_a被选为驱动表且数据量极大,而hash_area_size配置较小,系统将无法容纳全部数据。
发生内存溢出后数据库如何处理
一旦检测到内存不足以构建完整的哈希表,优化器或执行引擎会触发溢出处理机制。常见的做法是将驱动表按照哈希值划分为多个分区(Partition),每个分区的大小都在内存限制之内。系统会先处理第一个分区,将其加载到内存并构建哈希表,然后扫描探测表进行匹配;接着释放内存,处理下一个分区。这种多轮次的处理方式虽然保证了正确性,但显著增加了I/O开销。
-- 模拟分区处理的伪代码逻辑
FOR each partition p OF build_table:
    IF memory_available >= size(p):
        build_hash_table(p)
        probe_with(partition_table, hash_table)
    ELSE:
        fallback_to_nested_loop()
如何避免驱动表过大导致的性能下降
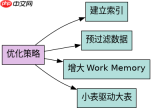
解决这一问题的核心在于控制驱动表的大小或增加可用内存。最直接的方法是通过索引或小表驱动大表的原则,确保参与Hash Join的小表作为驱动表。如果业务场景必须使用大表作为驱动表,则需要调整数据库参数如work_mem或hash_area_size以扩大内存配额。此外,对驱动表的关联键建立索引,或者在查询前对数据进行过滤以减少行数,也是有效的优化手段。



