






怎样在SQL中使用UPPER和LOWER做大小写不敏感匹配?
使用 upper() 或 lower() 函数将字段与常量同时转换为统一的大小写,即可实现大小写不敏感的精确匹配。例如查询条件写成 where upper(name) = 'john',这样无论数据库存储的是 'john'、'john' 还是 'john',都能被正确检索到。

为什么不建议在生产环境直接使用这些函数进行过滤?
直接在 WHERE 子句中对列应用 UPPER() 或 LOWER() 会导致数据库无法利用该列上的普通 B-Tree 索引,从而引发全表扫描,严重影响查询性能。
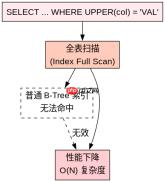
CREATE TABLE users (
    id INT PRIMARY KEY,
    name VARCHAR(50)
);

-- 低效写法:导致全表扫描
SELECT * FROM users WHERE UPPER(name) = 'ALICE';

-- 高效写法:利用函数索引
CREATE INDEX idx_upper_name ON users (UPPER(name));
SELECT * FROM users WHERE UPPER(name) = 'ALICE';
如果数据库支持 COLLATE 关键字,该如何替代函数转换?
大多数现代关系型数据库(如 MySQL、PostgreSQL、SQL Server)都支持通过 COLLATE 子句指定排序规则来实现大小写不敏感匹配,这种方式通常比使用函数更高效且语义更清晰。
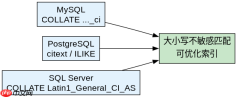
-- MySQL 示例:使用 utf8mb4_general_ci 排序规则
SELECT * FROM users WHERE name COLLATE utf8mb4_general_ci = 'Alice';

-- PostgreSQL 示例:使用 case-insensitive 扩展
CREATE EXTENSION IF NOT EXISTS citext;
SELECT * FROM users WHERE name::citext = 'Alice';


