






在sql存储过程中利用窗口函数简化复杂统计报表,核心做法是避免使用自连接或子查询进行多轮聚合,转而使用rank()、dense_rank()等函数配合over (partition by ... order by ...)子句,在单次扫描中完成分组排序和排名计算。这样做能显著减少临时表的创建和i/o开销,提升查询性能。若存在并列数据需要不同排名,应明确选择dense_rank()而非rank()。

如何获取每个部门薪资最高的员工
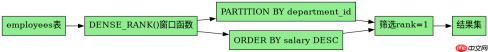
要获取每个部门薪资最高的员工,可以使用DENSE_RANK()窗口函数对每个部门的员工按薪资降序排列,然后筛选出排名为1的记录。这种方法比传统的自连接查询更简洁且易于维护。
WITH RankedEmployees AS (
    SELECT
        employee_id,
        department_id,
        salary,
        DENSE_RANK() OVER (PARTITION BY department_id ORDER BY salary DESC) as rank
    FROM employees
)
SELECT * FROM RankedEmployees WHERE rank = 1;
上述代码首先通过CTE(公共表表达式)计算每个员工的排名,然后在外层查询中筛选出排名为1的员工。假设输入数据如下:
employee_id | department_id | salary
1           | 1             | 5000
2           | 1             | 6000
3           | 2             | 7000
4           | 2             | 7000
5           | 3             | 8000
预期结果:
employee_id | department_id | salary | rank
2           | 1             | 6000   | 1
3           | 2             | 7000   | 1
4           | 2             | 7000   | 1
5           | 3             | 8000   | 1
如何计算累计销售额
要计算累计销售额,可以使用SUM()窗口函数配合ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW子句,实现从第一行到当前行的累加。这种方法适用于时间序列数据的累计分析。

SELECT
    sale_date,
    amount,
    SUM(amount) OVER (ORDER BY sale_date ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) as cumulative_amount
FROM sales;
上述代码通过SUM()窗口函数计算累计销售额。假设输入数据如下:
sale_date | amount
2023-01-01| 100
2023-01-02| 200
2023-01-03| 300
预期结果:
sale_date | amount | cumulative_amount
2023-01-01| 100    | 100
2023-01-02| 200    | 300
2023-01-03| 300    | 600
如何处理并列排名的情况
在处理并列排名的情况下,DENSE_RANK()会赋予相同值相同的排名,而RANK()则会跳过后续排名。例如,如果有两个员工薪资相同且均为最高,DENSE_RANK()会将它们都标记为第1名,而RANK()会将其中一个标记为第1名,另一个标记为第2名。


