






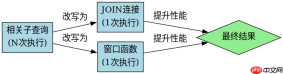
在sql中避免相关子查询对每行重复执行,最直接的办法是将相关子查询改写为join连接或窗口函数。这样数据库优化器可以将子查询提升为一次性执行的派生表或物化视图,从而将n+1次扫描降低为常数次扫描,显著提升处理速度。
如何将相关子查询改写为JOIN
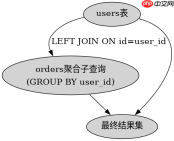
将相关子查询改写为JOIN是解决性能瓶颈的标准做法。通过将子查询中的过滤条件移至ON子句,并将SELECT字段移至主查询,可以消除逐行关联的执行模式。这种写法让优化器能够自由选择连接顺序和索引策略,通常能获得更好的执行计划。
SELECT u.id, u.name, o.total_amount
FROM users u
LEFT JOIN (
    SELECT user_id, SUM(amount) as total_amount
    FROM orders
    GROUP BY user_id
) o ON u.id = o.user_id;
上述代码展示了将原本在SELECT列表中的相关子查询提取到FROM子句中。通过预聚合订单数据并生成临时结果集,主查询只需进行一次哈希连接或嵌套循环,避免了为每个用户重新扫描订单表。预期结果是返回所有用户及其对应的总订单金额,未下单的用户total_amount为NULL。
何时使用窗口函数替代
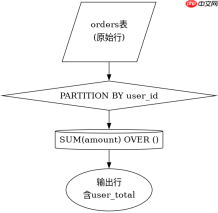
当需要保留原始行记录同时计算聚合值时,窗口函数是比JOIN更优的选择。它允许在不减少行数的前提下进行跨行计算,且语法简洁,无需处理JOIN可能带来的笛卡尔积膨胀问题。对于简单的排名或累计计算,窗口函数的执行效率通常高于自连接或子查询。
SELECT id, name, amount,
       SUM(amount) OVER (PARTITION BY user_id) as user_total
FROM orders;
该示例演示了使用SUM窗口函数直接计算每个用户的订单总额。与JOIN方案不同,这里不需要预先聚合,数据库会在排序后直接累加。预期输出包含每一笔订单的详细信息以及该订单所属用户的总金额。这种方法在处理大量明细数据时尤为有效,因为它避免了额外的分组和连接步骤。
基于GROUP BY子句的具体问题
在使用GROUP BY进行聚合时,如果SELECT列表中包含了非聚合列且未出现在GROUP BY中,会导致语法错误或逻辑混乱。必须确保所有非聚合字段都参与分组键,或者使用聚合函数包裹它们。这是编写正确聚合查询的基础规则。


