






oracle ash(active session history)比awr更适合分析偶发性性能抖动,核心原因在于其基于采样的高时间分辨率和细粒度数据。awr报告通常以15分钟或更长的间隔聚合数据,容易掩盖持续时间短于采样窗口的瞬时峰值;而ash每秒记录一次活跃会话状态,能够精准定位毫秒级到秒级的突发负载。要利用这一优势,应直接查询v$active_session_history视图,结合timestamp和event字段过滤特定时间段内的异常活动,从而还原抖动发生时的具体sql、等待事件及资源争用情况。
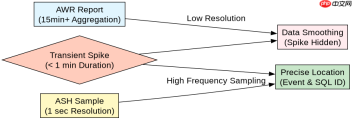
如何从ASH中定位具体的瞬时等待事件
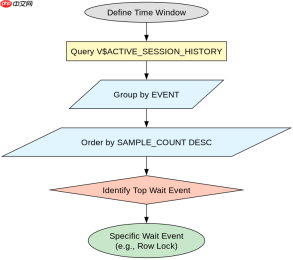
在确定存在性能抖动的时间窗口后,下一步是识别导致抖动的具体等待事件。通过查询V$ACTIVE_SESSION_HISTORY并统计EVENT列的分布,可以快速发现哪些等待占据了大部分活跃会话槽位。这种方法避免了AWR中因平均化而导致的细节丢失,直接暴露了瞬时的瓶颈点。
SELECT event, COUNT(*) sample_count
FROM v$active_session_history
WHERE sample_time BETWEEN TO_TIMESTAMP('2023-10-27 10:00:00', 'YYYY-MM-DD HH24:MI:SS')
                      AND TO_TIMESTAMP('2023-10-27 10:05:00', 'YYYY-MM-DD HH24:MI:SS')
GROUP BY event
ORDER BY sample_count DESC;
上述查询将返回在该5分钟窗口内各等待事件的采样次数。若发现某个非典型等待事件(如enq: TX - row lock contention)采样数显著高于平时,即表明该事件是抖动的直接诱因。开发者需关注sample_count与总活跃会话数的比例,高比例意味着该事件主导了当时的系统状态。
如何关联ASH采样获取导致抖动的具体SQL
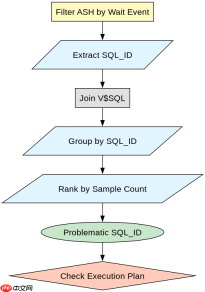
找到关键等待事件后,需要进一步查明是哪个SQL语句引发了这些等待。ASH视图中包含SQL_ID和CURRENT_OBJ#等关键字段,可以直接关联到具体的执行计划对象。通过提取高频出现的SQL_ID,并结合V$SQL视图获取文本,可以锁定问题根源。

SELECT sql_id, sql_text, COUNT(*) samples
FROM v$active_session_history ash
JOIN v$sql sql ON ash.sql_id = sql.sql_id
WHERE ash.sample_time BETWEEN TO_TIMESTAMP('2023-10-27 10:00:00', 'YYYY-MM-DD HH24:MI:SS')
                          AND TO_TIMESTAMP('2023-10-27 10:05:00', 'YYYY-MM-DD HH24:MI:SS')
  AND ash.event LIKE '%row lock%'
GROUP BY sql_id, sql_text
ORDER BY samples DESC;
此查询筛选出引发行锁等待的SQL,并按采样数排序。结果中的sql_id即为需要优化的目标。通过对比该SQL在正常时段与抖动时段的执行计划差异(使用V$SQL_PLAN),可判断是否因执行计划劣化导致了偶发性的资源争用。
当ASH数据中出现大量NULL的SQL_ID时意味着什么
在分析ASH数据时,常会遇到SQL_ID为NULL的情况,这通常发生在会话处于非SQL执行阶段,如PL/SQL循环、后台进程活动或系统调用期间。若抖动期间此类NULL记录占比极高,说明性能问题可能不在SQL逻辑本身,而在应用层的处理效率或数据库内部机制上。此时应转而分析SESSION_STATE和PROGRAM字段,排查应用代码中的死循环或长时间持有的非SQL操作。
,



