






如何从Oracle ASH报告中定位Top SQL
要正确解读oracle ash报告中的top sql指标,核心在于理解活动会话历史(active session history)的采样机制以及sql执行期间的资源消耗分布。通过查询`v$active_session_history`视图并结合`dba_hist_sqlstat`或`dba_hist_sqltext`,可以获取按时间、等待事件和cpu使用率排序的sql语句列表。重点关注`count(*)`代表的采样次数,它直接反映了该sql在特定时间段内占用的总活跃会话数,进而推算出其对系统资源的占用比例。同时,需结合`wait_class`区分是cpu密集型还是i/o密集型操作,以便进行针对性的优化。

在实际操作中,通常使用如下SQL来提取Top SQL信息。该查询会列出采样次数最多的前10条SQL,并计算其平均每次采样的等待时间。开发者应关注`SUM(1)`作为计数的基础,并通过`DECODE(WAIT_CLASS, 'CPU', 1, 0)`来识别纯CPU消耗。此外,`ELAPSED_TIME_DELTA`提供了更精确的时间维度,但需注意单位转换。通过这种组合查询,可以快速锁定那些长时间占用会话资源的瓶颈SQL。
SELECT s.sql_id, s.sql_text, COUNT(*) as sample_count, SUM(DECODE(s.wait_class, 'CPU', 1, 0)) as cpu_samples FROM v$active_session_history s WHERE s.sample_time BETWEEN SYSDATE - INTERVAL '1' HOUR AND SYSDATE GROUP BY s.sql_id, s.sql_text ORDER BY sample_count DESC FETCH FIRST 10 ROWS ONLY;
运行上述代码后,预期结果将返回一个包含`sql_id`、`sql_text`、`sample_count`和`cpu_samples`的结果集。例如,某条SQL可能显示`sample_count`为500,而`cpu_samples`为450,表明该SQL主要消耗CPU资源。开发者应根据这些指标进一步分析执行计划,检查是否存在全表扫描或索引缺失等问题。若`cpu_samples`占比低但`sample_count`高,则需重点排查I/O等待或锁竞争情况。
如何区分Top SQL中的CPU与等待事件
区分Top SQL中的CPU与等待事件是优化性能的关键步骤,因为不同的等待类型指向截然不同的解决方案。在ASH数据中,`WAIT_CLASS`字段明确标识了会话当前的状态类别,如'CPU'、'User I/O'、'Concurrency'等。通过分析这些分类,可以判断SQL的性能瓶颈是源于计算复杂度还是外部资源争用。对于CPU密集型SQL,优化方向通常是调整执行计划或增加并行度;而对于I/O密集型SQL,则可能需要优化索引结构或调整存储配置。
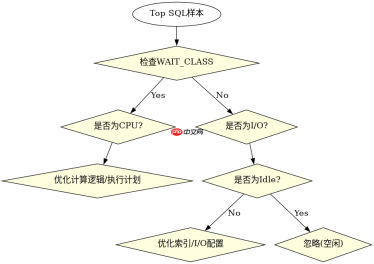

为了更清晰地展示这一过程,可以使用以下SQL查询来统计每个SQL在不同等待类别下的采样分布。这将帮助开发者直观地看到哪些SQL主要在等待什么类型的资源。特别需要注意的是,当`WAIT_CLASS`为'Idle'时,通常表示会话处于空闲状态,不应被视为性能问题的一部分。因此,在筛选Top SQL时,建议排除'Idle'类别的采样,以确保分析的准确性。
SELECT sql_id, wait_class, COUNT(*) as samples FROM v$active_session_history WHERE sample_time BETWEEN SYSDATE - INTERVAL '1' HOUR AND SYSDATE AND wait_class != 'Idle' GROUP BY sql_id, wait_class ORDER BY sql_id, samples DESC;
执行上述查询后,预期结果将显示每条SQL在不同等待类别下的采样数量。例如,某条SQL可能在'User I/O'下有300个采样,而在'CPU'下仅有50个采样。这表明该SQL的主要瓶颈在于磁盘I/O,而非计算能力。开发者应据此调整优化策略,如添加合适的索引以减少物理读,或者考虑使用异步I/O技术来提升I/O效率。通过这种方式,可以精准定位问题根源,避免盲目优化。
基于程序中某个输入、条件或结果的具体问题
在分析过程中,如果输入的SQL文本包含特殊字符或长文本,可能会导致解析错误或显示异常。例如,某些SQL语句可能包含单引号、双引号或其他转义字符,这在直接嵌入到查询字符串中时会引发语法错误。为解决这一问题,建议在构建动态SQL时使用参数化查询或绑定变量,以避免字符串拼接带来的风险。此外,对于超长SQL文本,可以考虑截断显示或使用专门的工具进行格式化,以提高可读性。
假设我们有一个具体的场景:某条SQL语句中包含大量嵌套子查询,导致`sql_text`字段内容过长,影响后续处理。此时,可以通过设置`MAXLEN`参数或使用`SUBSTR`函数来限制输出长度。例如,使用`SUBSTR(sql_text, 1, 100)`可以截取前100个字符,便于快速浏览。同时,确保在数据库层面启用适当的日志记录机制,以便捕获完整的SQL文本供深入分析。这种方法不仅提高了数据处理的安全性,还增强了系统的可维护性。


