






java iterator 遍历策略模式通过定义统一的 iterator 接口,将集合的遍历逻辑与具体数据结构解耦。实现时,只需让自定义集合类实现 iterable 接口并返回具体的迭代器实例,即可在外部使用增强 for 循环或手动调用 hasnext() 和 next() 进行遍历。这种设计允许在不修改集合核心代码的前提下,灵活切换不同的遍历策略(如顺序、逆序或过滤遍历)。
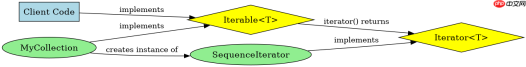
如何为自定义集合提供默认的顺序遍历
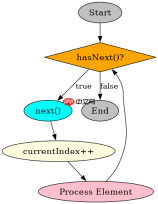
要让自定义集合支持默认的增强 for 循环,必须实现 Iterable 接口,并在 iterator() 方法中返回一个实现了 Iterator 的内部类实例。该内部类需维护当前索引,并在 next() 中返回元素并递增索引,同时在 hasNext() 中检查索引是否越界。这样,外部代码无需关心集合内部是数组还是链表,统一通过迭代器访问数据。
import java.util.Iterator;

public class MyCollection<t> implements Iterable<t> {
    private Object[] items = new Object[10];
    private int size = 0;

    public void add(T item) {
        if (size  iterator() {
        return new SequenceIterator();
    }

    private class SequenceIterator implements Iterator<t> {
        private int currentIndex = 0;

        @Override
        public boolean hasNext() {
            return currentIndex  coll = new MyCollection();
        coll.add("A");
        coll.add("B");
        for (String s : coll) {
            System.out.println(s);
        }
    }
}</t></t></t>
运行上述代码,控制台将依次输出 A 和 B。这验证了通过实现 Iterable 接口,自定义集合能够无缝接入 Java 的标准遍历机制,且内部数组结构对使用者完全透明。
如何在遍历时动态应用过滤策略
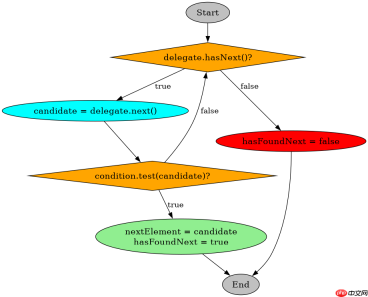
若需在遍历过程中应用特定条件(如仅遍历偶数),可创建另一个实现 Iterator 的类,例如 FilteringIterator。该类持有原始迭代器和一个 java.util.function.Predicate 函数式接口。在 next() 调用前,先循环调用底层迭代器的 next() 直到找到满足条件的元素或耗尽集合。这种方式允许在运行时注入不同的过滤逻辑,而无需改变集合本身的存储方式。

import java.util.Iterator;
import java.util.function.Predicate;

public class FilteredCollection<t> implements Iterable<t> {
    private MyCollection<t> source;
    private Predicate<t> filter;

    public FilteredCollection(MyCollection<t> source, Predicate<t> filter) {
        this.source = source;
        this.filter = filter;
    }

    @Override
    public Iterator<t> iterator() {
        return new FilteringIterator(source.iterator(), filter);
    }

    private class FilteringIterator implements Iterator<t> {
        private Iterator<t> delegate;
        private Predicate<t> condition;
        private T nextElement;
        private boolean hasFoundNext;

        public FilteringIterator(Iterator<t> delegate, Predicate<t> condition) {
            this.delegate = delegate;
            this.condition = condition;
            findNext();
        }

        private void findNext() {
            while (delegate.hasNext()) {
                T candidate = delegate.next();
                if (condition.test(candidate)) {
                    nextElement = candidate;
                    hasFoundNext = true;
                    return;
                }
            }
            hasFoundNext = false;
        }

        @Override
        public boolean hasNext() {
            return hasFoundNext;
        }

        @Override
        public T next() {
            if (!hasNext()) throw new java.util.NoSuchElementException();
            T result = nextElement;
            findNext();
            return result;
        }
    }

    public static void main(String[] args) {
        MyCollection<integer> coll = new MyCollection();
        coll.add(1); coll.add(2); coll.add(3); coll.add(4);

        FilteredCollection<integer> filtered = new FilteredCollection(coll, n -> n % 2 == 0);
        for (Integer n : filtered) {
            System.out.println(n);
        }
    }
}</integer></integer></t></t></t></t></t></t></t></t></t></t></t></t>
运行此段代码,控制台仅输出 2 和 4。这表明 FilteredCollection 成功拦截了原始迭代器的输出,并根据传入的 Lambda 表达式过滤了奇数,展示了策略模式在遍历过程中的动态扩展能力。
当过滤条件不匹配任何元素时迭代器行为如何
在 FilteringIterator 的实现中,如果所有元素都不满足过滤条件,findNext() 方法会遍历完整个底层集合并将 hasFoundNext 设为 false。此时调用 hasNext() 将返回 false,增强 for 循环不会执行任何体内容。若在 hasNext() 为 false 时强行调用 next(),则会抛出 NoSuchElementException。这是符合 Java 迭代器规范的标准行为,确保了程序在空结果集下的安全性。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


