






java preparedstatement 执行批量数据分区通常指将大量数据按特定逻辑(如日期、id范围)拆分为多个批次,分批提交到数据库以减少内存占用并提高事务稳定性。具体做法是遍历数据集,根据分区条件判断当前记录归属哪个批次,当累积的批次大小达到阈值或分区切换时,调用 addbatch() 和 executebatch() 进行提交,最后清空批次。preparedstatement 本身不自动分区,需由业务代码控制循环与提交时机。
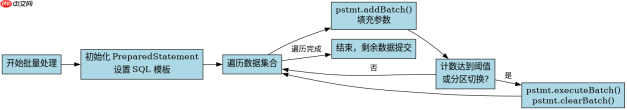
如何按固定数量进行简单批量提交
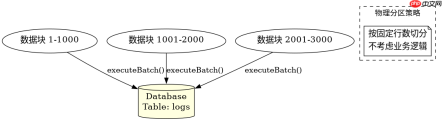
最简单的批量处理方式是忽略业务逻辑分区,仅按物理行数进行切分。通过维护一个计数器,每添加一定数量的参数后执行一次 executeBatch(),可以有效防止 JDBC 驱动因持有过多未发送语句而耗尽内存。这种方式适用于数据之间无强关联且无需按业务键隔离的场景。
import java.sql.Connection;
import java.sql.PreparedStatement;
import java.util.List;

public class SimpleBatchProcessor {
    public void process(List<string> data, Connection conn) throws Exception {
        String sql = "INSERT INTO logs (message) VALUES (?)";
        try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
            int count = 0;
            int batchSize = 1000;
            for (String msg : data) {
                pstmt.setString(1, msg);
                pstmt.addBatch();
                count++;
                if (count % batchSize == 0) {
                    pstmt.executeBatch();
                    pstmt.clearBatch();
                }
            }
            if (count % batchSize != 0) {
                pstmt.executeBatch();
            }
        }
    }
}</string>
上述代码中,batchSize 设为 1000,意味着每处理 1000 条记录就会向数据库发送一次指令。这种策略下,所有数据最终都会进入同一个表分区(如果表没有按时间分区),但应用层的内存压力被均匀分散。若数据量极大,建议适当调小 batchSize 以匹配 JVM 堆空间。
如何按业务字段值进行逻辑分区提交
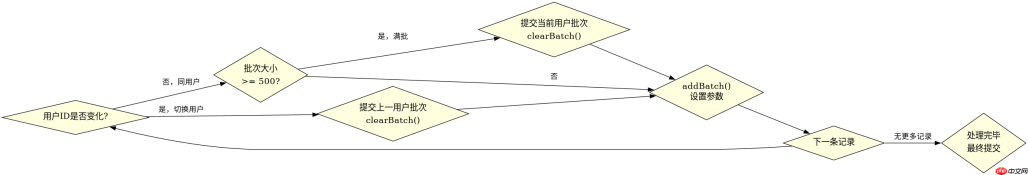
当需要确保同一业务实体(如相同用户 ID 或订单号)的数据在同一个事务批次中提交时,必须实现基于字段的逻辑分区。做法是在循环中比较当前记录的关键字段与前一条记录是否一致,若不一致则先提交前一批次,再开启新批次。这能避免跨批次的部分更新导致的数据不一致问题。

import java.sql.Connection;
import java.sql.PreparedStatement;
import java.util.List;
import java.util.Map;

public class LogicalBatchProcessor {
    public void processByUser(List<map object>> records, Connection conn) throws Exception {
        String sql = "INSERT INTO user_actions (user_id, action) VALUES (?, ?)";
        try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
            String lastUserId = null;
            int batchSize = 500;

            for (Map<string object> record : records) {
                String userId = (String) record.get("user_id");
                String action = (String) record.get("action");

                // 检查是否需要切换分区(用户ID变化)
                if (lastUserId != null && !lastUserId.equals(userId)) {
                    pstmt.executeBatch();
                    pstmt.clearBatch();
                }

                pstmt.setString(1, userId);
                pstmt.setString(2, action);
                pstmt.addBatch();

                // 检查物理批次大小
                if (pstmt.getMaxRows() == 0 || pstmt.getParameterMetaData().getParameterCount() == 0) {
                     // 这里简化处理,实际应统计已add的数量
                }

                lastUserId = userId;
            }
            pstmt.executeBatch();
        }
    }
}</string></map>
在实际实现中,通常需要额外维护一个计数器来监控物理批次大小,因为逻辑分区点可能稀疏。如果某个用户的操作记录超过 batchSize,需要在该用户内部再次触发 executeBatch()。这种双重控制机制确保了既满足业务逻辑的原子性,又控制了单次网络传输的数据量。注意 PreparedStatement 的 clearBatch() 必须在 executeBatch() 之后调用,否则会导致数据丢失。
当批量插入遇到主键冲突时会发生什么
在执行批量分区提交时,如果某一批次中包含重复的主键值,数据库通常会抛出异常(如 MySQL 的 DuplicateKeyException)。由于 executeBatch() 默认是原子性的,一旦批次中任何一条语句失败,整个批次都会回滚,之前成功插入的记录也会失效。这意味着开发者必须预先处理数据去重,或者使用 ON DUPLICATE KEY UPDATE 等语法来容忍冲突,否则会导致部分数据丢失。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


