python 的内存占用通常比 php 低,因为 python 是通用编程语言,没有内置的 web 服务器生命周期开销,而 php 每次请求都需要启动解释器、加载扩展并初始化 sapi 环境。在实现相同功能时,php 的常驻内存(rss)往往更高,尤其是在使用框架或大量全局变量时。要降低 php 内存占用,应减少不必要的对象实例化并使用 `unset()` 及时释放引用;要优化 python,则需避免深层嵌套的数据结构并合理使用生成器。
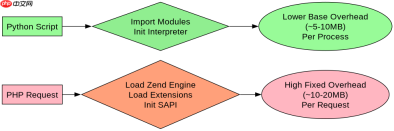
PHP 请求生命周期带来的额外内存开销
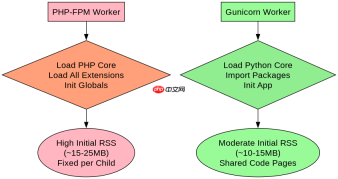
PHP 的内存占用高主要源于其“每个请求一个进程”的设计模式。当处理一个 HTTP 请求时,Web 服务器(如 Nginx 或 Apache)会 fork 出一个新的 PHP-FPM 子进程或线程。这个子进程需要加载 Zend 引擎、所有已启用的扩展(如 PDO、GD、JSON),并初始化全局变量表。即使你的脚本只执行一行代码,这些基础结构的内存分配也是固定的。相比之下,Python 脚本通常作为独立进程运行或由 WSGI 服务器管理,虽然也有启动成本,但可以通过持久化进程复用(如 Gunicorn workers)来分摊开销,且 Python 的解释器本身在内存管理上更为灵活,允许更细粒度的控制。
import sys

def php_like_overhead():
    # 模拟 PHP 请求启动时的固定开销
    # 包括:Zend Engine, Extensions, Global Variables
    fixed_overhead = 10 * 1024 * 1024  # 假设 10MB 基础开销
    return fixed_overhead

def python_script_memory():
    # Python 脚本实际使用的内存
    data = [i for i in range(1000)]
    return sys.getsizeof(data)

print(f"PHP Fixed Overhead: {php_like_overhead()} bytes")
print(f"Python Data Memory: {python_script_memory()} bytes")
上述代码展示了两种语言在内存测量上的差异。PHP 的 `fixed_overhead` 代表了每次请求必须承担的静态成本,而 Python 的 `data` 仅计算了实际数据结构的占用。在实际部署中,PHP-FPM 的 `pm.max_children` 设置直接决定了并发能力与总内存占用的平衡,而 Python 的 Gunicorn worker 数量同样影响内存,但其单个 worker 的初始内存 footprint 通常小于 PHP-FPM 进程。
数据结构与垃圾回收机制对内存的影响
Python 和 PHP 在垃圾回收(GC)机制上的不同也影响了内存占用的表现。Python 使用引用计数为主、分代 GC 为辅的机制,能够及时释放不再引用的对象,但循环引用可能导致内存泄漏,除非显式处理或使用 `weakref`。PHP 7+ 引入了改进的 GC 算法,能够检测并清理循环引用,但其 GC 触发阈值和频率可能不如 Python 的引用计数响应迅速。此外,Python 的对象模型更加统一,所有对象都是堆分配的,这增加了元数据开销,但也提供了更高的灵活性。PHP 的变量容器(zval)在早期版本中较为复杂,PHP 7 后通过分离读写值减少了内存拷贝,但在处理大型数组时,PHP 的哈希表实现仍可能产生较高的碎片率。

import gc

def test_python_gc():
    # 创建循环引用
    class Node:
        def __init__(self):
            self.ref = None

    node1 = Node()
    node2 = Node()
    node1.ref = node2
    node2.ref = node1

    del node1
    del node2

    # 强制 GC 以验证循环引用是否被清理
    collected = gc.collect()
    print(f"Python GC Collected: {collected} objects")

test_python_gc()
该 Python 示例演示了循环引用的清理过程。虽然 `del` 操作解除了外部引用,但内部相互引用仍需 GC 介入。PHP 的类似场景也会触发 GC,但其默认阈值较高,可能在长时间运行的 CLI 脚本中导致内存持续增长,直到达到阈值才进行清理。因此,在 Python 中,对于长期运行的服务,建议定期调用 `gc.collect()` 或在关键路径后手动清理大对象,而在 PHP 中,则需注意 `memory_limit` 的设置和 GC 阈值的调整。
如何根据具体输入条件优化内存占用
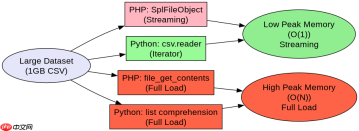
在处理大规模数据集时,PHP 和 Python 的内存表现差异尤为明显。例如,当读取一个 1GB 的 CSV 文件时,PHP 如果使用 `file_get_contents()` 一次性加载,将直接耗尽内存;而 Python 使用 `csv.reader` 迭代器可以逐行处理,内存占用几乎恒定。这种差异源于 PHP 倾向于将数据整体加载到内存中进行处理,而 Python 的生成器和迭代器模式鼓励流式处理。为了优化 PHP 的内存占用,应使用 `SplFileObject` 或 `fgetcsv()` 逐行读取,并避免将大数组存储在内存中。对于 Python,则应确保使用生成器而非列表推导式来处理大数据流,以避免中间结果的内存累积。
import csv
import os

def process_csv_python(file_path):
    total_size = 0
    with open(file_path, 'r') as f:
        reader = csv.reader(f)
        for row in reader:
            # 逐行处理,不加载整个文件
            total_size += sum(len(str(cell)) for cell in row)
    return total_size

def process_csv_php_simulation():
    # PHP 伪代码逻辑:使用 SplFileObject 逐行读取
    # $file = new SplFileObject('data.csv');
    # while (!$file->eof()) {
    #     $row = $file->fgetcsv();
    #     // process row
    # }
    pass

# 假设 file_path 存在且有效
# result = process_csv_python(file_path)
此代码展示了 Python 如何通过迭代器模式高效处理大文件。PHP 的 `SplFileObject` 提供了类似的流式处理能力,避免了 `file_get_contents()` 的全量加载风险。在实际应用中,选择哪种方式取决于数据规模和可用内存。对于小数据量,两者的差异可忽略不计;但对于大数据量,Python 的迭代器模式和 PHP 的流式对象都能显著降低内存峰值,从而支持更高的并发或更大的数据处理任务。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!