






php中中文文件名下载乱码是因为浏览器对非ascii字符的编码处理不同,直接输出会导致解析错误。解决办法是使用 urlencode() 或 rawurlencode() 对文件名进行url编码,并在 content-disposition 头中指定 filename*=utf-8' 格式,这样现代浏览器能正确识别并解码中文文件名。

Content-Disposition 头部的标准写法是什么
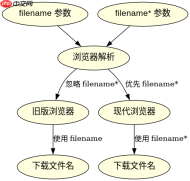
标准写法是将文件名分为 filename 和 filename* 两部分。filename 用于兼容旧版浏览器,通常使用ISO-8859-1编码或ASCII;filename* 遵循RFC 5987标准,明确指定UTF-8编码。代码中通过拼接这两个部分,确保大多数浏览器都能正确处理。
<?php $file = 'example.pdf';
$filePath = '/path/to/' . $file;

if (file_exists($filePath)) {
    header('Content-Description: File Transfer');
    header('Content-Type: application/octet-stream');
    header('Content-Disposition: attachment; filename="' . basename($file) . '"; filename*=UTF-8\'' . rawurlencode($file) . '\'');
    header('Expires: 0');
    header('Cache-Control: must-revalidate');
    header('Pragma: public');
    header('Content-Length: ' . filesize($filePath));
    readfile($filePath);
    exit;
}
?>
运行上述代码后,浏览器会提示下载 example.pdf,且文件名显示为正确的中文(如果 $file 是中文)。注意 filename* 的值必须用单引号包裹,且前缀为 UTF-8'。
为什么需要同时提供 filename 和 filename*
因为不同浏览器对 Content-Disposition 头的支持程度不同。旧版IE可能忽略 filename*,而只读取 filename;现代浏览器则优先使用 filename* 以支持UTF-8。同时提供两者可以最大化兼容性。

<?php // 测试不同浏览器的行为
$testFiles = ['中文文件.pdf', 'english.pdf'];
foreach ($testFiles as $file) {
    echo "Testing: " . $file . "<br>";
    // 实际下载逻辑同上,此处仅示意
}
?>
通过遍历不同文件名,可以验证代码在不同场景下的表现。确保 filename 部分不包含非ASCII字符,以避免旧版浏览器解析错误。
如果文件名包含特殊字符如空格或括号怎么办
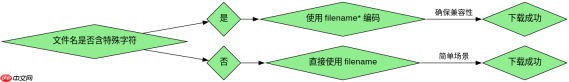
特殊字符在 filename 中可能导致解析问题,因此建议始终使用 filename* 并提供UTF-8编码。对于 filename,可以使用 basename() 获取纯文件名,并用 urlencode() 编码。例如,文件名 my file (1).pdf 会被编码为 my%20file%20%281%29.pdf,确保浏览器正确解析。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





