






将 fetch 批量请求拆分为多个批次,通过 promise.all 并发执行每批任务,并在批次间使用 settimeout 或 requestidlecallback 让出主线程控制权,从而避免长任务阻塞 ui。具体做法是定义一个分批函数,接收总任务列表和每批大小参数,循环处理并等待异步完成。

如何限制单次并发数量以避免内存溢出
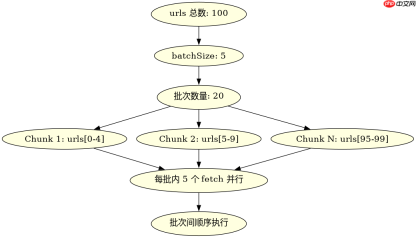
通过控制 Promise.all 中的并发队列大小来实现。将总任务切分为固定大小的 chunk,依次对每个 chunk 调用 Promise.all,确保同一时刻只有有限数量的网络请求在运行。
async function batchFetch(urls, batchSize = 5) {
  const results = [];
  for (let i = 0; i  fetch(url).then(r => r.json()))
    );
    results.push(...batchResults);
    // 让出主线程
    if (i + batchSize  setTimeout(resolve, 0));
    }
  }
  return results;
}
上述代码中,urls 为待请求的 URL 数组,batchSize 为每批并发数。当 urls 长度为 100,batchSize 为 5 时,程序会分 20 批执行,每批 5 个请求同时发出,批次间暂停 0ms 以允许浏览器渲染帧。
如何处理单个请求失败的情况
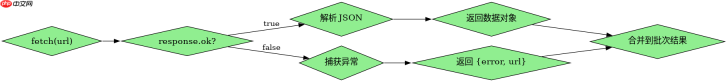
在 map 内部使用 try-catch 包裹 fetch 调用,捕获异常后返回特定错误对象或 null,确保 Promise.all 不会因单个失败而中断整个批次。

async function safeBatchFetch(urls, batchSize = 5) {
  const results = [];
  for (let i = 0; i  {
        try {
          const response = await fetch(url);
          if (!response.ok) throw new Error(`HTTP ${response.status}`);
          return await response.json();
        } catch (e) {
          console.error(`Failed to fetch ${url}:`, e.message);
          return { error: e.message, url };
        }
      })
    );
    results.push(...batchResults);
    if (i + batchSize  setTimeout(resolve, 0));
    }
  }
  return results;
}
该版本在遇到网络错误或 HTTP 状态码非 2xx 时,返回包含 error 和 url 字段的结果对象,而非抛出异常。这样即使部分请求失败,其他请求仍能正常处理,且批次不会中断。
基于输入 urls 长度动态调整批次策略的具体问题
当 urls 长度小于 batchSize 时,无需分批,直接一次性执行即可;当 urls 长度极大时,可结合 requestIdleCallback 进一步降低 CPU 占用率,但核心逻辑仍依赖切片与并发控制。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





