






排查 nginx 代理超时引发的重复请求,核心在于区分是客户端重试还是 nginx 内部的重试机制。通常表现为日志中出现相同的 $request_id 或上游响应时间异常,需检查 proxy_next_upstream 配置及客户端行为。
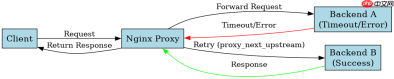
proxy_next_upstream 如何导致 Nginx 主动重试
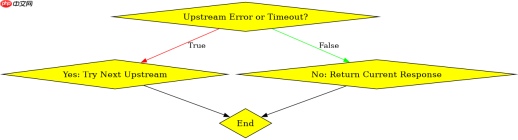
Nginx 的 proxy_next_upstream 指令在检测到特定错误(如超时、502 Bad Gateway)时,会自动将请求转发给下一个上游服务器,这在日志中看起来像重复请求。默认情况下,Nginx 会在连接错误或超时后尝试下一个节点,这可能导致同一个请求被处理多次。
server {
    listen 80;
    location /api/ {
        # 仅在超时或错误时重试下一个上游
        proxy_next_upstream error timeout;
        proxy_next_upstream_tries 2;

        proxy_pass http://backend_pool;
        proxy_connect_timeout 5s;
        proxy_read_timeout 10s;
    }
}
上述配置中,如果第一个上游服务器在 5 秒内未建立连接或 10 秒内未返回数据,Nginx 会将请求发送给 backend_pool 中的下一个服务器。这意味着同一个 HTTP 请求可能被后端处理两次,若后端接口非幂等,将引发数据重复问题。
客户端超时与 Nginx 超时的交互影响
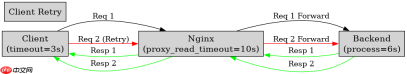
当客户端设置的超时时间短于 Nginx 的上游读取超时时间时,客户端会断开连接并重试,而 Nginx 可能仍在等待上游响应。这种时间差会导致 Nginx 记录到“已完成的请求”,但客户端认为失败并发起新请求,造成逻辑上的重复。

# 客户端 curl 示例:设置 3 秒超时
curl --max-time 3 http://nginx_server/api/data

# Nginx 配置:上游读取超时设为 10 秒
location /api/ {
    proxy_read_timeout 10s;
    proxy_pass http://backend_pool;
}
在此场景下,如果后端处理耗时 6 秒,Nginx 会继续等待直到 10 秒超时,期间客户端已在 3 秒时断开并重试。Nginx 最终会向第二个客户端请求返回结果,导致后端执行了两次业务逻辑。排查时需确保客户端超时时间略小于 Nginx 的 proxy_read_timeout,或通过日志关联 $request_id 来识别此类情况。
如何通过日志确认请求是否被重复处理
通过检查 Nginx 访问日志中的 $request_id 和 $upstream_response_time,可以明确判断请求是否被 Nginx 内部重试。如果同一时间戳出现多个相同 URI 的请求,且 $status 均为 200,但 $upstream_addr 不同,则说明发生了上游切换重试。
在日志格式中加入 $request_id 和 $upstream_addr 字段,例如:log_format main '$remote_addr - $request_id - $upstream_addr - $status';。分析日志时,筛选出相同 $request_id 的多条记录,若它们指向不同的 $upstream_addr,即可确认为 Nginx 的 proxy_next_upstream 机制导致的重复请求。此时应评估后端接口的幂等性,或调整 proxy_next_upstream 以限制重试条件。





