






贪婪模式会尽可能多地匹配字符,而懒惰模式(非贪婪)会尽可能少地匹配。选择 . 还是 .*? 取决于你是否需要捕获到第一个分隔符之前的内容:若需精确截取首个标签或引号内的短文本,使用 .*?;若需匹配直到字符串末尾或最后一个分隔符的长文本,使用 .。
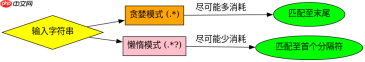
如何验证贪婪与懒惰模式的匹配差异
通过对比同一正则表达式在贪婪和懒惰模式下的匹配结果,可以直观看到两者对输入字符串的处理方式不同。贪婪模式会消耗掉所有可能的字符,直到无法继续匹配为止;懒惰模式则在满足最小匹配条件后立即停止。以下代码演示了这两种模式在处理包含多个相同字符的字符串时的具体表现。
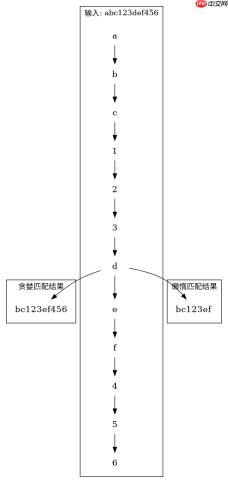
<?php $subject = "abc123def456";

// 贪婪模式:尽可能多匹配
preg_match("/a(.*)d/", $subject, $matches_greedy);
echo "Greedy: " . $matches_greedy[1] . "\n"; // 输出: bc123ef456

// 懒惰模式:尽可能少匹配
preg_match("/a(.*?)d/", $subject, $matches_lazy);
echo "Lazy: " . $matches_lazy[1] . "\n"; // 输出: bc123ef
运行上述代码,贪婪模式返回从第一个 a 到最后一个 d 之间的所有内容,而懒惰模式仅返回从第一个 a 到第一个 d 之间的内容。这种差异在处理 HTML 标签、JSON 字段或日志行时尤为关键,错误选择可能导致捕获到错误的范围。
何时应优先使用懒惰模式以避免过度捕获
当目标文本中包含重复的分隔符或结束标记时,必须使用懒惰模式以防止匹配范围过大。例如,在提取 HTML 标签内容或 JSON 键值对时,贪婪模式可能会跨越多个结构单元,导致数据污染。以下代码展示了在解析简单 HTML 片段时,两种模式产生的不同结果。

<?php $html = "<p>Hello<p>World</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill5233" title="btpanel phpsite 宝塔面板PHP网站"><img
														src="https://img.php.cn/upload/skill/000/000/081/179040786932301.jpg" alt="btpanel phpsite 宝塔面板PHP网站" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill5233" title="btpanel phpsite 宝塔面板PHP网站" class="overflowclass">btpanel phpsite 宝塔面板PHP网站</a>
													<p class="overflowclass">宝塔面板 PHP 网站管理:站点创建、删除、启停、PHP 版本切换、域名管理、SSL证书管理、伪静态管理、数据库管理</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill5233" title="btpanel phpsite 宝塔面板PHP网站" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div>";

// 贪婪模式:可能捕获整个字符串直到最后一个
preg_match("/<p>(.*?)/", $html, $matches_lazy);
echo "Lazy Match: " . $matches_lazy[1] . "\n"; // 输出: Hello

// 若误用贪婪模式 /</p><p>(.*)/,将得到: Hello</p><p>World</p>
在上述示例中,懒惰模式 (.*?) 确保只捕获第一个 和第一个
(.*),正则引擎会一直向后搜索,直到找到最后一个 基于输入字符串中连续相同字符的具体匹配问题
当输入字符串中存在连续相同的字符或嵌套结构时,贪婪与懒惰模式的选择直接决定了捕获组的完整性。例如,在处理由多个连字符组成的 ID 或路径时,若未正确指定量词的模式,可能会导致截断或溢出。以下代码针对一个包含多个连字符的特定输入,展示如何通过调整模式来精确获取目标片段。
<?php $path = "/usr/local/bin/php";

// 尝试获取最后一个目录名
preg_match("/[^\/]+$/", $path, $matches);
echo "Filename: " . $matches[0] . "\n"; // 输出: php

// 若需获取倒数第二个目录
preg_match("/([^\/]+)\/[^\/]+$/", $path, $matches);
echo "Directory: " . $matches[1] . "\n"; // 输出: bin
在该场景中,[^\/]+$ 利用锚点 $ 强制匹配从末尾开始的最短非斜杠序列,这本质上是一种隐式的懒惰行为,因为正则引擎从右向左寻找第一个非斜杠块。若改为 /([^\/]+)/ 而不加锚点,贪婪模式将从左向右匹配第一个非斜杠块,即 usr,这与预期结果不符。因此,在处理路径或类似结构化文本时,结合锚点与适当的量词是确保匹配准确性的关键。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


