






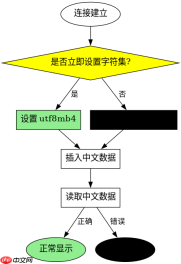
因为 set_charset() 负责设置当前连接的字符集,如果不在连接后立即调用,后续执行的 sql 语句会使用默认的或之前设置的字符集进行解析。当客户端发送中文数据时,若服务器端认为的字符集与客户端实际发送的不一致,就会导致乱码。必须在建立连接后、执行任何查询前立即调用,以确保整个会话期间的字符编码转换正确。

为什么延迟调用会导致乱码?
如果在连接建立后没有立即设置字符集,MySQL 服务器会尝试使用默认字符集(通常是 latin1 或 utf8mb4,取决于服务器配置)来解释客户端发来的数据。假设你的数据库和表都设计为使用 utf8mb4,但客户端连接初始状态是 latin1。当你插入一个中文字符 "中" 时,客户端将其作为 utf8mb4 字节序列发送(例如 E4 B8 AD)。如果服务器此时误以为这是 latin1 编码,它可能不会进行正确的转换,或者在存储/读取时产生误解。更常见的情况是,如果你先执行了查询,服务器已经按照错误的字符集解释了 SQL 语句中的字符串字面量,导致存入的数据就是错的。即使后来调用了 set_charset('utf8mb4'),之前错误存入的数据无法自动修复,且后续操作虽然正确了,但历史数据依然乱码。因此,必须在第一次交互前确立正确的字符集上下文。
$link = new mysqli("host", "user", "pass", "db");
if ($link->connect_error) {
    die("Connection failed: " . $link->connect_error);
}
// 必须立即调用
$link->set_charset("utf8mb4");
$sql = "INSERT INTO users (name) VALUES ('张三')";
$link->query($sql);
预期结果:数据库中 users 表的 name 字段正确存储并显示为 "张三",无乱码。
不设置字符集时的具体表现是什么?
如果不显式调用 set_charset(),PHP 的 MySQLi 扩展可能会使用系统默认字符集或连接时协商的字符集。在许多旧版 PHP 或服务器配置中,默认可能是 latin1。当插入包含多字节字符(如中文)的数据时,如果客户端声明的字符集与服务器期望的不匹配,服务器会将多字节字节流错误地解释为多个单字节字符,或者在返回结果时进行错误的转义。这通常表现为问号 ?、方块 □ 或完全不可读的符号。此外,如果 SQL 语句中包含中文注释或标识符,也可能因解析错误而失败。关键在于,字符集设置影响的是连接层面的数据传输协议,一旦连接建立,这个设置就固定了,除非再次调用 set_charset() 更改。因此,延迟调用意味着在“未定义”或“错误”的字符集状态下进行了数据交换。

安装、修复、更新或打包一个基于 Python 和 PyMySQL 实现的 Windows `mysql` 命令。适用于用户希望在 PowerShell/CMD 中输入 `mysql` 时重定向到 Python 实现、需要交互式输入 MySQL 连接信息、需要同步到当前用户本地 bin 目录,或需要将该能力封装成可公开复用的 Codex skill。

$link = new mysqli("host", "user", "pass", "db");
// 未调用 set_charset
$sql = "SELECT name FROM users WHERE id = 1";
$result = $link->query($sql);
$row = $result->fetch_assoc();
echo $row['name']; // 可能输出乱码
预期结果:如果数据库中存在中文数据,且连接未正确设置字符集,echo 输出的内容将是乱码,如 中文 对应的字节被错误解码后的显示。
基于程序中输入 '张三' 的存储问题
当程序中输入为 "张三" 时,如果未在连接后立即调用 set_charset('utf8mb4'),该字符串将被以错误的字符集处理。具体来说,"张" 和 "三" 在 UTF-8 中各占 3 个字节。如果服务器端误认为是 Latin1,它可能只看到部分字节或进行错误转换,导致存入数据库的字节序列与预期不符。读取时,同样因为字符集不匹配,这些字节会被错误解码,最终呈现为乱码。只有确保连接初始化阶段就设置了正确的字符集,才能保证从输入到存储再到输出的全过程编码一致。








