






输入待整理的项目文件夹、原始文件名列表及自定义命名规则,关键操作在于构建结构化映射表、处理命名冲突并在副本环境中验证逻辑,最终产出符合规范且无重复的新文件名清单。此方法通过先预览后执行的策略,确保批量操作的安全性与准确性。
构建清晰的命名映射规则
面对杂乱的项目资料,首要任务是建立统一的命名逻辑。不要直接让工具执行重命名,而是先定义角色与任务结构。例如,设定ai为“文件整理专家”,明确任务是将散乱文档归类并命名。输入材料包括当前文件的目录结构和初步的分类标准,如按类型(合同、设计稿)、日期或项目阶段划分。输出格式要求生成一个包含原文件名与新文件名的对照表。这种结构化的指令能让工具更准确地理解意图,避免随意生成的混乱名称。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
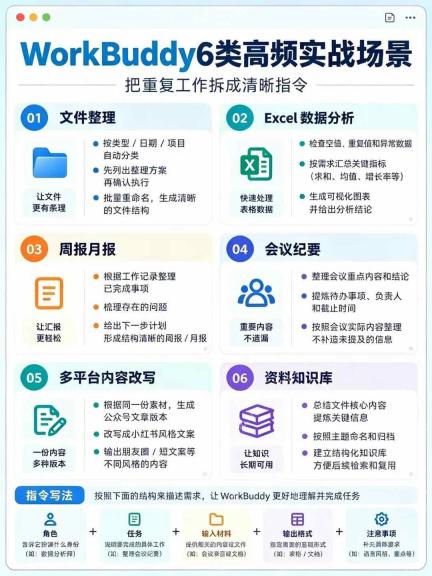
在指令中补充注意事项至关重要,指定语言风格需简洁专业,重点突出文件的核心属性。通过这种方式,可以将重复性的整理工作转化为清晰的指令序列。工具会依据设定的规则,自动提取文件关键信息,如日期或版本标识,并将其嵌入新文件名中,从而形成条理清晰的文件结构。这一步骤是后续批量操作的基础,确保所有命名遵循同一套逻辑体系。
识别并处理同名冲突
在生成映射表预览时,必须仔细检查是否存在潜在的同名冲突。当多个不同内容的文件被映射到相同的新文件名时,直接执行会导致覆盖错误。判断标准是查看映射表中是否有重复的“新文件名”列值。若发现冲突,需立即调整命名规则,增加区分度更高的字段,如添加序号、作者缩写或具体日期后缀。例如,将“报告.pdf”改为“20231025_张三_报告_v1.pdf”,以唯一标识每个文件。
- 检查映射表中新文件名列的唯一性
- 对冲突项追加时间戳或人员标识
- 确认修改后的映射表无重复条目
处理冲突的过程也是优化命名规则的机会。如果冲突频繁出现,说明初始规则过于宽泛。此时应细化输入材料的分类维度,或者引入更精确的元数据作为命名依据。确保每一张图、每一份文档都有独立的身份标识,这是实现高效检索和长期复用的前提。只有在映射表完全无误且无冲突的情况下,才能进入下一步的执行环节。
在副本环境中安全试跑
切勿直接在原始项目文件夹上运行批量重命名脚本。正确的做法是创建一个与原文件夹结构相同的副本,或在沙盒环境中进行模拟执行。将生成的映射表应用于副本中的文件,观察实际重命名结果是否符合预期。这一步骤相当于一次完整的预演,能够暴露出路径错误、权限问题或特殊字符导致的失败案例。通过对比副本前后的文件状态,可以直观地验证命名逻辑的正确性。
试跑过程中,重点关注那些边缘情况,如包含空格、特殊符号或超长字符的文件名是否被正确处理。如果发现副本中的文件命名仍存在问题,返回调整指令中的注意事项部分,修正规则细节。只有当副本中的所有文件都按照预定规则整齐排列,且无任何报错或异常时,才具备在生产环境执行的条件。这种谨慎的操作流程能最大程度降低数据丢失风险。
执行最终批量重命名
确认副本试跑成功后,即可在原始项目文件夹中应用最终的映射表。使用支持批量操作的工具备份原始文件列表,然后执行重命名动作。执行完毕后,再次核对文件总数是否与原始一致,随机抽取几个文件检查新名称是否准确反映其内容属性。例如,检查“设计稿”类文件是否都带有“DSGN”前缀,日期格式是否统一。这一最后的核对步骤确保了整个流程的闭环,使项目资料真正变得有条理,便于后续的协作与归档。





