输入目标PDF文件及需保留的连续页码区间,关键操作是通过提示词明确指定起始与结束页码并执行拆分任务,产出为仅包含指定页面的独立新PDF文件。
区分实际页序与印刷页码
处理长文档时,pdf的实际文件页序往往与封面标注的印刷页码不一致。例如一份200页的报告,前10页可能是目录和前言,从第11页开始才是正文第一章。若直接按“第10-20页”提取,可能误取到目录内容而非正文。因此,在调用工具前,务必先打开原文件确认物理页码分布,确保输入的数值对应真实的页面位置,避免逻辑错误。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
构建精确的拆分提示词
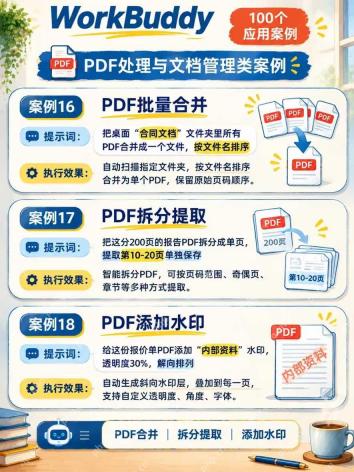
使用本地副本进行批量或单次处理时,提示词需具备明确的动作指令和范围限定。以提取特定章节为例,不应只说“拆分PDF”,而应具体描述为“把这分200页的报告PDF拆分成单页,提取第10-20页单独保存”。这种表述方式能引导系统识别出需要保留的连续区间,并忽略其他无关页面。重点在于聚焦于‘保留’哪些页面,而非泛泛地提及合并或添加水印等其他功能。

员工在试用 WorkBuddy 时,经常会冒出"这个要是能一键就好了"的念头,但往往转头就忘。本技能把这类反馈零摩擦地沉淀到企业统一表格: 1. 不用跳出当前工作流、不用重复填姓名和部门; 2. 身份一次配置,后续只说内容即可; 3. 自动对齐表头、追加一行,企业方可直接统计。 触发方式 在对话中表达"提交 / 记录一条反馈"的意图即可触发,例如: - 反馈一个需求 · 提个诉求 · 记录一下这个痛点 - 收集反馈 · 提交体验反馈 · feedback - 完成
把这分200页的报告PDF拆分成单页,
提取第10-20页单独保存
验证输出文件的首尾内容
任务执行完毕后,不能仅依赖文件名判断结果,必须打开生成的新文件检查首尾两页。首先确认第一页是否为预期的起始页(如报告的第10页),其次确认最后一页是否为预期的结束页(如报告的第20页)。这一步骤能有效排除因页码偏移导致的提取偏差,确保最终交付的文档片段完整且准确,符合后续阅读或归档的需求。