C#值类型和引用类型的赋值差异是什么
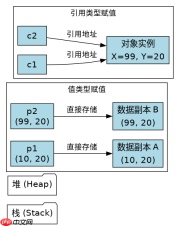
在c#中,值类型(如 int、struct)的变量直接存储数据,而引用类型(如 class、string)的变量存储的是指向堆内存的地址。理解两者差异的关键在于赋值操作:对值类型进行赋值时,系统会复制一份完整的数据副本;而对引用类型进行赋值时,系统仅复制该对象的内存地址,两个变量将指向同一个对象实例。
using System;

public class Program
{
    public struct PointStruct
    {
        public int X, Y;
    }

    public class PointClass
    {
        public int X, Y;
    }

    public static void Main()
    {
        // 值类型赋值测试
        PointStruct p1 = new PointStruct { X = 10, Y = 20 };
        PointStruct p2 = p1; // 复制数据
        p2.X = 99;
        Console.WriteLine($"Struct: p1=({p1.X},{p1.Y}), p2=({p2.X},{p2.Y})");

        // 引用类型赋值测试
        PointClass c1 = new PointClass { X = 10, Y = 20 };
        PointClass c2 = c1; // 复制引用
        c2.X = 99;
        Console.WriteLine($"Class: c1=({c1.X},{c1.Y}), c2=({c2.X},{c2.Y})");
    }
}
运行上述代码后,控制台输出显示:Struct: p1=(10,20), p2=(99,20) 以及 Class: c1=(99,20), c2=(99,20)。这证实了修改 p2 不会影响 p1,因为它们是独立的内存块;而修改 c2 会直接影响 c1,因为它们共享同一块堆内存。
为什么修改引用类型的一个变量会影响另一个变量
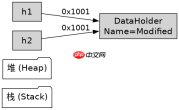
这是因为引用类型在栈上只保存了一个指向堆中对象的指针。当执行 c2 = c1 时,c2 获得了与 c1 相同的指针值。此时,c1 和 c2 就像两根不同的绳子拴着同一只气球,拉动其中一根(修改属性),另一根看到的也是同样的变化。
using System;

public class Program
{
    public class DataHolder
    {
        public string Name;
    }

    public static void Main()
    {
        DataHolder h1 = new DataHolder { Name = "Original" };
        DataHolder h2 = h1;

        // 通过 h2 修改对象状态
        h2.Name = "Modified";

        // 验证 h1 的状态
        Console.WriteLine(h1.Name);
    }
}
预期结果为 Modified。由于 h1 和 h2 指向同一个 DataHolder 实例,任何一方的修改都会反映在另一方身上。这种机制在处理大型对象时非常高效,因为它避免了昂贵的内存拷贝操作,但也要求开发者注意避免意外的副作用。

如果我想让引用类型也像值类型一样独立该怎么办
如果需要让引用类型具备值类型的独立性,必须手动创建一个新的实例并复制其属性,或者使用深拷贝技术。默认的赋值操作不会自动完成这一过程,它始终只是复制引用。因此,在需要隔离状态的场景下,不能依赖简单的等号赋值。
using System;

public class Program
{
    public class DataHolder
    {
        public string Name;
    }

    public static void Main()
    {
        DataHolder h1 = new DataHolder { Name = "Original" };

        // 手动创建新实例实现“值类型”般的独立
        DataHolder h2 = new DataHolder { Name = h1.Name };

        h2.Name = "Modified";

        Console.WriteLine(h1.Name);
    }
}
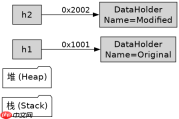
预期结果为 Original。通过 new DataHolder 显式分配了新的内存空间,h2 不再指向 h1 的对象。虽然这在语义上模拟了值类型的行为,但在性能上仍不如原生值类型,因为依然涉及堆分配。对于简单的数据结构,直接使用 struct 是更优的选择。