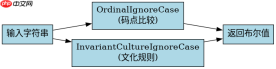
stringcomparison.ordinalignorecase 和 stringcomparison.invariantcultureignorecase 的主要区别在于比较时使用的字符映射规则不同:前者基于 unicode 码点(code point)进行逐字节或逐字素的二进制比较,速度极快且结果确定;后者则基于不变区域性(invariant culture)的文本排序规则,会处理大小写折叠、重音符号等语言特性。如果你只需要判断两个字符串是否“看起来”一样(忽略大小写),通常应优先选择 ordinalignorecase,因为它更简单、更快且避免了区域性带来的意外行为。
为什么 OrdinalIgnoreCase 比 InvariantCultureIgnoreCase 更快?
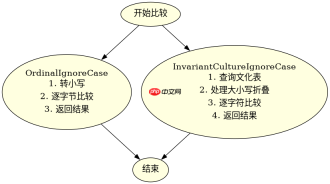
OrdinalIgnoreCase 之所以性能更高,是因为它直接比较字符的数值(Unicode 码点)。在 .NET 中,这通常意味着将字符串转换为小写后直接比较内存中的字节序列,或者使用专门的 SIMD 指令进行并行比较。而 InvariantCultureIgnoreCase 需要查询内部的文化数据表,执行复杂的转换逻辑,例如将德语的 ß 转换为 ss,或者将带重音的字母归一化。这种额外的查表和转换开销使得它在处理长字符串或高频调用场景下明显慢于序数比较。

InvariantCultureIgnoreCase