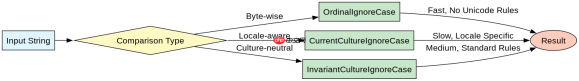
在c#中验证忽略大小写比较逻辑时,最容易遗漏的是非ascii字符中的特殊大小写映射(如德语ß、土耳其语i/i)以及组合字符序列。推荐使用string.equals配合stringcomparison.ordinalignorecase进行快速且安全的字节级比较,或者使用stringcomparer.ordinalignorecase作为字典键以确保一致性。对于需要符合unicode标准的复杂文化敏感比较,应使用stringcomparison.currentcultureignorecase或cultureinfo.invariantculture,但需注意性能开销和特定区域设置(如土耳其语)带来的意外行为。
为什么OrdinalIgnoreCase会漏掉某些“相等”的字符串?
OrdinalIgnoreCase基于UTF-16编码单元的逐位比较,它不执行Unicode规范化或语言特定的大小写转换。这意味着像“fi”(单个连字字符U+FB01)和“fi”(两个字符)在这种模式下被视为不相等,尽管在某些视觉呈现或语言规则下它们可能被视为相同。此外,全角与半角字符(如“A”与“A”)也会被判定为不同。
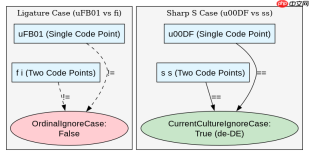
using System;
using System.Globalization;

class Program
{
    static void Main()
    {
        // 示例1:连字字符 vs 普通字母
        string ligature = "\uFB01"; // fi
        string normal = "fi";

        Console.WriteLine($"Ligature: {ligature} (CodePoints: {string.Join(",", ligature.Select(c => ((int)c).ToString("X4")))})");
        Console.WriteLine($"Normal:   {normal} (CodePoints: {string.Join(",", normal.Select(c => ((int)c).ToString("X4")))})");

        bool ordinalEq = string.Equals(ligature, normal, StringComparison.OrdinalIgnoreCase);
        bool invariantEq = string.Equals(ligature, normal, StringComparison.InvariantCultureIgnoreCase);

        Console.WriteLine($"OrdinalIgnoreCase Equal: {ordinalEq}");
        Console.WriteLine($"InvariantIgnoreCase Equal: {invariantEq}");

        // 示例2:德语 ß vs ss
        string sharpS = "ß";
        string ss = "ss";

        Console.WriteLine($"\nSharpS: {sharpS} (CodePoints: {string.Join(",", sharpS.Select(c => ((int)c).ToString("X4")))})");
        Console.WriteLine($"SS:     {ss} (CodePoints: {string.Join(",", ss.Select(c => ((int)c).ToString("X4")))})");

        bool ordinalEq2 = string.Equals(sharpS, ss, StringComparison.OrdinalIgnoreCase);
        bool currentEq = string.Equals(sharpS, ss, StringComparison.CurrentCultureIgnoreCase);

        Console.WriteLine($"OrdinalIgnoreCase Equal: {ordinalEq2}");
        Console.WriteLine($"CurrentCultureIgnoreCase Equal: {currentEq}");
    }
}
如何处理组合字符导致的比较不一致?
当输入包含重音符号或其他组合字符时,Unicode允许同一字符有多种表示形式(NFC、NFD、NFKC、NFKD)。例如,“é”可以是单个字符U+00E9,也可以是“e”加上重音符号U+0301的组合。如果不对字符串进行规范化,即使使用CurrentCultureIgnoreCase,也可能因为底层码元序列不同而导致比较失败或哈希冲突。解决方案是在比较前调用Normalize(NormalizationForm.FormC)。

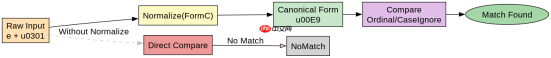
using System;
using System.Globalization;

class Program
{
    static void Main()
    {
        // 示例:组合字符 vs 预组合字符
        string precomposed = "\u00E9"; // é (U+00E9)
        string composed = "e\u0301";    // e + combining acute accent

        Console.WriteLine($"Precomposed: {precomposed} (Length: {precomposed.Length})");
        Console.WriteLine($"Composed:    {composed} (Length: {composed.Length})");

        // 未规范化直接比较
        bool directEq = string.Equals(precomposed, composed, StringComparison.Ordinal);
        bool directIgEq = string.Equals(precomposed, composed, StringComparison.OrdinalIgnoreCase);

        Console.WriteLine($"\nDirect Ordinal Equal: {directEq}");
        Console.WriteLine($"Direct OrdinalIgnoreCase Equal: {directIgEq}");

        // 规范化后比较
        string nfcPre = precomposed.Normalize(NormalizationForm.FormC);
        string nfcComp = composed.Normalize(NormalizationForm.FormC);

        bool nfcEq = string.Equals(nfcPre, nfcComp, StringComparison.Ordinal);

        Console.WriteLine($"\nAfter NFC Normalize Equal: {nfcEq}");
        Console.WriteLine($"NFC Precomposed Length: {nfcPre.Length}");
        Console.WriteLine($"NFC Composed Length: {nfcComp.Length}");
    }
}
在字典中使用忽略大小写的键时,哪些情况会导致异常或数据丢失?
在使用Dictionary并指定StringComparer.OrdinalIgnoreCase时,主要风险在于哈希码的计算方式。虽然OrdinalIgnoreCase能正确识别逻辑相等的字符串,但如果插入的两个字符串在OrdinalIgnoreCase下相等但在原始字节上不同(如“ABC”和“abc”),字典会视为同一个键。然而,如果使用的是默认的StringComparer.Ordinal,则“ABC”和“abc”会被视为不同的键。更隐蔽的问题出现在涉及区域性敏感字符时,例如在土耳其语区域设置下,“I”的小写是“ı”,而“i”的大写是“İ”。如果使用CurrentCultureIgnoreCase作为字典的比较器,必须确保所有操作都在相同的区域设置上下文中进行,否则可能导致查找失败。此外,如果键字符串在插入后被修改(虽然字符串不可变,但如果是可变对象包装),会导致哈希表内部状态不一致。