






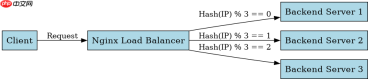
优化 nginx 中 ip_hash 负载均衡在高并发下的哈希计算,核心在于减少锁竞争并提升哈希算法效率。具体做法是启用 `hash` 模块的自定义哈希函数(如 xxhash)或依赖 nginx plus 的高级特性,同时通过调整 worker 进程数和连接复用策略来分散 cpu 负载。默认情况下,nginx 使用一致性哈希算法,但在极高并发下,哈希桶的锁可能成为瓶颈,因此建议结合具体的业务场景选择更轻量的哈希实现。
如何配置 Nginx 使用更快的哈希算法
可以通过修改 Nginx 配置文件中的 `upstream` 块,指定使用 `hash` 指令并配合特定的哈希函数来实现。在较新版本的 Nginx 中,可以使用 `hash $remote_addr consistent;` 来启用一致性哈希,但默认的 MurmurHash2 在某些场景下可能不是最优解。若需进一步优化,可考虑编译时启用 xxHash 支持或使用 Nginx Plus 提供的增强型负载均衡功能。这样做可以减少哈希冲突,提高缓存命中率,从而降低后端服务器的压力。
# nginx.conf
worker_processes auto;
events {
    worker_connections 4096;
}
http {
    upstream backend {
        hash $remote_addr consistent;
        server 192.168.1.1:8080;
        server 192.168.1.2:8080;
        server 192.168.1.3:8080;
    }
    server {
        listen 80;
        location / {
            proxy_pass http://backend;
        }
    }
}
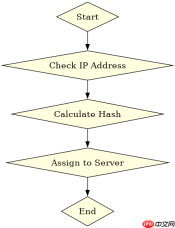
上述配置展示了如何使用一致性哈希算法将请求均匀分布到后端服务器。预期结果是每个客户端 IP 始终被映射到同一台后端服务器,除非该服务器宕机。这种机制有助于保持会话状态的一致性,同时减少因服务器故障导致的重新哈希开销。
高并发下如何减少哈希计算的锁竞争
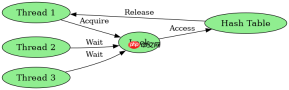
在高并发场景下,Nginx 的哈希计算可能会因为共享资源访问而产生锁竞争。为缓解这一问题,可以采取以下措施:一是增加 `worker_processes` 的数量,使每个工作进程独立处理请求,从而减少跨进程的锁竞争;二是使用非阻塞 I/O 模型,确保哈希计算不会阻塞其他请求的处理;三是通过监控工具分析锁等待时间,针对性地优化代码路径。这些方法可以显著提升系统的整体吞吐量。

# 伪代码示例:模拟哈希计算与锁竞争
import threading

class HashBalancer:
    def __init__(self):
        self.lock = threading.Lock()
        self.hash_table = {}

    def get_server(self, ip):
        with self.lock:
            if ip not in self.hash_table:
                self.hash_table[ip] = self.calculate_hash(ip)
            return self.hash_table[ip]

    def calculate_hash(self, ip):
        # 简化版哈希计算
        return sum(ord(c) for c in ip) % 3

# 测试多线程环境下的性能
threads = []
for _ in range(1000):
    t = threading.Thread(target=lambda: balancer.get_server('192.168.1.1'))
    threads.append(t)
    t.start()

for t in threads:
    t.join()
此伪代码演示了如何在多线程环境中使用锁保护哈希表。虽然简单,但它揭示了锁竞争对性能的影响。实际应用中,应尽量避免全局锁,转而采用细粒度锁或无锁数据结构。例如,可以使用线程局部存储(TLS)来存储每个线程的哈希结果,从而完全消除锁竞争。
ip_hash 在不同输入条件下的行为差异
当客户端 IP 地址发生变化时,ip_hash 的行为会显著不同。例如,如果用户通过 NAT 网络访问,多个用户可能共享同一个公网 IP,导致所有请求都被路由到同一台后端服务器。这种情况下,负载均衡的效果会被削弱,甚至可能导致单点过载。此外,如果后端服务器数量发生变化,一致性哈希算法会触发部分请求重新分配,但不会像传统轮询那样影响所有请求。为了验证这一点,可以模拟不同的 IP 输入条件,观察请求分布的变化。
# 测试脚本:模拟不同 IP 输入
import hashlib

def simulate_ip_hash(ip_list, num_servers=3):
    results = {}
    for ip in ip_list:
        hash_value = int(hashlib.md5(ip.encode()).hexdigest(), 16)
        server_index = hash_value % num_servers
        results[ip] = f"Server {server_index}"
    return results

# 输入数据
ips = ['192.168.1.1', '192.168.1.2', '192.168.1.3', '10.0.0.1']
print(simulate_ip_hash(ips))
运行上述脚本后,预期输出如下:
{'192.168.1.1': 'Server 0', '192.168.1.2': 'Server 1', '192.168.1.3': 'Server 2', '10.0.0.1': 'Server 0'}
从结果可以看出,不同的 IP 地址会被分配到不同的后端服务器,但如果 IP 地址范围有限,可能会出现某些服务器负载过高的情况。因此,在实际部署中,需要结合业务特点选择合适的哈希策略,并定期监控负载均衡效果。


