






java iterator 遍历大数据量时,内存优化的核心在于避免一次性将全部数据加载到内存中,而是采用流式处理或分批拉取的方式。具体做法是确保底层数据源支持延迟加载(lazy loading),例如使用 jdbc 的 setfetchsize、jpa 的 scrollmode 或数据库游标,让 iterator 每次只从数据库或文件系统中读取一小批数据到堆内存。这样无论数据总量多大,内存占用始终保持在批次大小级别,从而防止 outofmemoryerror。
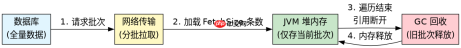
JDBC 游标如何控制单次加载行数
JDBC 默认情况下会将查询结果集全量拉取到客户端内存,导致大数据量下内存溢出。通过设置 Statement 或 ResultSet 的 fetchSize 参数,可以告诉驱动每次只获取指定数量的行。配合正确的驱动配置,Iterator 在调用 next() 时才会触发下一批数据的网络传输和内存分配,实现真正的流式遍历。
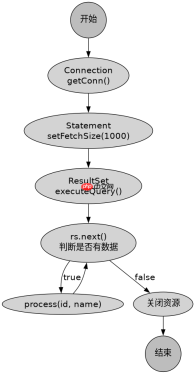
import java.sql.*;

public class JdbcIteratorExample {
    public static void main(String[] args) throws Exception {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        // 1. 建立连接
        Connection conn = DriverManager.getConnection(url, user, password);

        // 2. 创建 Statement 并设置 fetchSize
        Statement stmt = conn.createStatement();
        stmt.setFetchSize(1000); // 关键:每次只加载 1000 行

        // 3. 执行查询
        ResultSet rs = stmt.executeQuery("SELECT id, name FROM large_table");

        // 4. 使用 Iterator 遍历
        while (rs.next()) {
            int id = rs.getInt("id");
            String name = rs.getString("name");
            process(id, name); // 处理单条数据,旧数据可被 GC 回收
        }

        // 5. 关闭资源
        rs.close();
        stmt.close();
        conn.close();
    }

    private static void process(int id, String name) {
        // 业务逻辑
    }
}
预期结果:
- stmt.setFetchSize(1000) 生效。
- 内存峰值仅容纳约 1000 个对象。
- 遍历过程平稳,无 OOM。
JPA ScrollableIterator 如何实现分页流式读取
JPA 的 Query.getResultList() 同样会加载所有实体到一级缓存和堆内存。要优化,需使用 ScrollMode.SCROLL_INSENSITIVE 或 STREAM 模式获取 ScrollableResults 或 Stream。这种方式利用数据库游标,每次只持久化当前批次的数据到 EntityManager 缓存,遍历完后可手动清除缓存或依赖批次边界释放内存,避免无限增长。

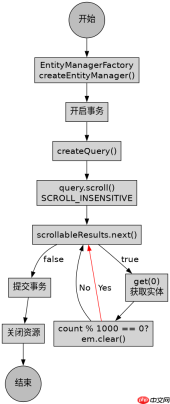
import javax.persistence.*;
import java.util.Iterator;

public class JpaScrollableExample {
    public static void main(String[] args) {
        EntityManagerFactory emf = Persistence.createEntityManagerFactory("pu");
        EntityManager em = emf.createEntityManager();

        try {
            EntityTransaction tx = em.getTransaction();
            tx.begin();

            Query query = em.createQuery("SELECT e FROM Entity e");

            // 关键:使用 ScrollableResults 进行流式读取
            ScrollableResults scrollableResults = query.scroll(ScrollMode.SCROLL_INSENSITIVE);

            int count = 0;
            while (scrollableResults.next()) {
                Entity entity = (Entity) scrollableResults.get(0);
                process(entity);
                count++;

                // 可选:每处理 N 条后清除缓存,防止一级缓存膨胀
                if (count % 1000 == 0) {
                    em.clear();
                }
            }

            tx.commit();
        } catch (Exception e) {
            e.printStackTrace();
        } finally {
            em.close();
            emf.close();
        }
    }

    private static void process(Entity entity) {
        // 业务逻辑
    }
}
预期结果:
- query.scroll() 返回 ScrollableResults。
- em.clear() 定期清理一级缓存。
- 内存占用稳定在批次大小 + 少量缓存对象。
Iterator 遍历时如何处理空值或异常中断
在流式遍历过程中,如果某条数据解析失败或为空,直接抛出异常会导致整个事务回滚且未处理的数据丢失。正确的做法是在 process() 方法内部捕获异常,记录日志并跳过该条数据,或者将错误数据写入独立的错误队列。这样 Iterator 可以继续遍历后续数据,保证整体处理的鲁棒性,同时通过监控错误率来排查数据质量问题。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


