






字节流和字符流的核心区别在于处理数据的单位不同:字节流以字节(8位)为单位进行读写,而字符流以字符(16位 unicode)为单位进行读写。在实际开发中,如果需要处理文本文件且涉及中文等多字节字符,应优先使用字符流以避免乱码;若处理图片、音频等非文本二进制数据,则必须使用字节流。
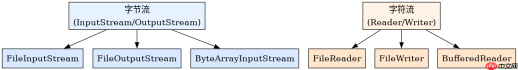
字节流与字符流的继承体系有何不同
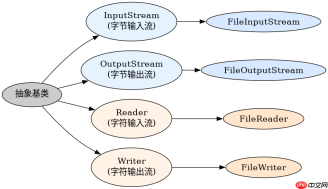
字节流和字符流在 Java IO 体系中拥有各自独立的类层次结构。字节流的基类是 InputStream 和 OutputStream,所有子类都直接继承自这两个抽象类。字符流的基类则是 Reader 和 Writer,它们专门用于处理字符序列。这种分离设计使得开发者可以根据数据类型选择最合适的流类型,避免不必要的转换开销。
import java.io.*;

public class StreamHierarchy {
    public static void main(String[] args) {
        // 字节流示例
        InputStream byteIn = new FileInputStream("data.bin");
        OutputStream byteOut = new FileOutputStream("output.bin");

        // 字符流示例
        Reader charIn = new FileReader("text.txt");
        Writer charOut = new FileWriter("result.txt");

        System.out.println("Byte stream type: " + byteIn.getClass().getName());
        System.out.println("Char stream type: " + charIn.getClass().getName());
    }
}
缓冲机制对两种流的影响是什么
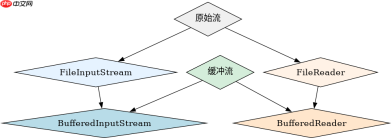
缓冲机制可以显著提升 I/O 性能,但字节流和字符流在实现缓冲的方式上有所不同。字节流通常通过 BufferedInputStream 和 BufferedOutputStream 来添加缓冲功能,而字符流则通过 BufferedReader 和 BufferedWriter 来实现。缓冲区的存在减少了系统调用的次数,从而提高了读写效率。对于大文件的处理,建议始终使用带缓冲的流。

import java.io.*;

public class BufferedStreams {
    public static void main(String[] args) throws IOException {
        // 带缓冲的字节流
        InputStream bufferedByteIn = new BufferedInputStream(new FileInputStream("large.bin"));
        OutputStream bufferedByteOut = new BufferedOutputStream(new FileOutputStream("large_out.bin"));

        // 带缓冲的字符流
        Reader bufferedCharIn = new BufferedReader(new FileReader("large_text.txt"));
        Writer bufferedCharOut = new BufferedWriter(new FileWriter("large_result.txt"));

        System.out.println("Buffered byte stream: " + bufferedByteIn.getClass().getSimpleName());
        System.out.println("Buffered char stream: " + bufferedCharIn.getClass().getSimpleName());
    }
}
编码转换在字符流中是如何处理的
字符流在处理文本时会自动进行编码转换,这是它与字节流最大的区别之一。当使用 FileReader 或 FileWriter 时,Java 会根据操作系统的默认字符集进行编码和解码。如果需要指定特定的编码格式,可以使用 InputStreamReader 和 OutputStreamWriter 包装字节流。这种自动转换机制简化了文本处理,但也可能导致跨平台时的编码不一致问题。
,
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


