






java 中 hashset 和 linkedhashset 的选择取决于是否需要保持插入顺序。如果不需要保证元素遍历的顺序,优先使用 hashset,因为它底层基于哈希表,内存占用更少且操作性能更优;如果需要保持元素的插入顺序(即先添加的元素先被遍历),则必须使用 linkedhashset,它通过维护一个双向链表来记录插入顺序,虽然增加了少量的内存开销,但能确保迭代结果与添加顺序一致。
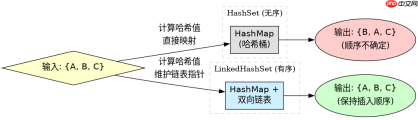
如何验证 HashSet 不保证顺序
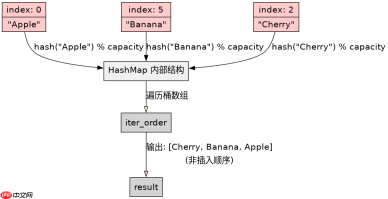
要验证 HashSet 不保证顺序,可以向其中添加一组整数并遍历输出。由于 HashSet 内部使用哈希值决定存储位置,遍历时的顺序通常是无序的,甚至在不同运行或不同 JDK 版本中可能表现不同。以下代码展示了向 HashSet 添加元素后的实际遍历结果,你会发现它们并非按添加顺序排列。
import java.util.HashSet;
import java.util.Set;

public class HashSetDemo {
    public static void main(String[] args) {
        Set<string> set = new HashSet();
        set.add("Apple");
        set.add("Banana");
        set.add("Cherry");
        System.out.println(set);
    }
}</string>
预期输出示例:[Cherry, Banana, Apple](顺序可能因环境而异,但肯定不是 [Apple, Banana, Cherry])。
如何验证 LinkedHashSet 保持插入顺序
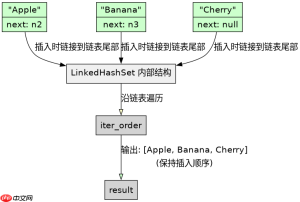
要验证 LinkedHashSet 保持插入顺序,可以使用相同的输入数据。将上述代码中的 HashSet 替换为 LinkedHashSet,再次遍历集合。此时,输出的顺序将严格遵循元素添加的顺序,即先添加的 "Apple" 会最先出现在遍历结果中。这证明了 LinkedHashSet 在保留唯一性的同时,额外提供了有序性保障。

import java.util.LinkedHashSet;
import java.util.Set;

public class LinkedHashSetDemo {
    public static void main(String[] args) {
        Set<string> set = new LinkedHashSet();
        set.add("Apple");
        set.add("Banana");
        set.add("Cherry");
        System.out.println(set);
    }
}</string>
预期输出:[Apple, Banana, Cherry]。
当 LinkedHashSet 遇到重复元素时结果如何
当向 LinkedHashSet 中添加重复元素时,它会忽略新加入的重复项,并保持原有元素的插入位置和顺序不变。例如,如果在已添加 "Apple", "Banana" 后再次添加 "Apple",集合内容仍为 ["Apple", "Banana"],且遍历顺序不受影响。这体现了 LinkedHashSet 既具备 Set 的唯一性约束,又具备链表的顺序特性,重复插入不会改变现有结构的顺序逻辑。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


