






strlen() 统计中文偏大是因为它直接返回字符串在内存中占用的字节数,而不是字符的数量。在 utf-8 编码下,一个汉字通常占用 3 个字节,所以长度会被放大 3 倍。字节是数据存储的最小单位,而字符是人类可读的最小单位,两者在多字节编码中不是一一对应的关系。

strlen() 对多字节字符串的具体行为是什么
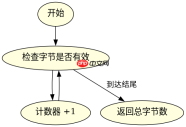
strlen() 函数只关心字节流,它会遍历字符串直到遇到空终止符 \0,并计算经过的字节总数。对于包含中文的 UTF-8 字符串,每个汉字由 3 个字节组成,因此 strlen("你好") 会返回 6。这种机制在处理 ASCII 字符时没有问题,但在处理多字节编码时会显得“不准确”,因为它无法识别字符边界。
<?php $str = "你好";
$bytes = strlen($str);
echo $bytes; // 输出 6
?>
预期结果:变量 $bytes 的值为整数 6,因为字符串 "你好" 在 UTF-8 编码下占用 6 个字节。
如何正确获取中文字符串的长度
要获取正确的字符数量,应使用 mb_strlen() 函数并指定编码为 UTF-8。该函数能够解析多字节编码,识别出每个汉字的完整结构,从而返回准确的字符计数。例如 mb_strlen("你好", "UTF-8") 会返回 2。这是处理国际化文本时的标准做法,确保逻辑基于字符而非底层存储单元。


<?php $str = "你好";
$chars = mb_strlen($str, "UTF-8");
echo $chars; // 输出 2
?>
预期结果:变量 $chars 的值为整数 2,因为字符串 "你好" 包含 2 个字符。
当输入为空字符串时 mb_strlen() 返回什么
当输入为空字符串 "" 时,mb_strlen() 会返回 0。这与 strlen() 的行为一致,因为空字符串不包含任何字节或字符。这一结果验证了函数在边界条件下的稳定性,确保在判断字符串是否为空时,可以使用长度值进行精确比较。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


