





近日,由英伟达与麻省理工学院研究人员联合组建的 efficient-large-model 团队,在 hugging face 平台正式开源视频增强项目 open-h3-regenerate-2k 的模型权重,配套推理代码已同步发布于 nvlabs/sana 仓库。该方案基于 minimax h3 架构,可将低分辨率视频草稿升频重建为高分辨率视频,原生支持 2560 × 1440 的 2k 输出,并具备扩展至 3840 × 2160 原生 4k 重生成的能力。
MiniMax H3 的完整技术栈涵盖多模态上下文理解、基础音视频合成及高分辨率细化再生等核心模块。其中,已公开权重的 H3-Base 模块负责生成 768P 分辨率的音视频内容;而官方 H3-Regenerate-2K 则以 API 形式提供服务。本次发布的 Open-H3-Regenerate-2K 项目复用了 H3 基础模型的生成能力,首次为高分辨率重生成环节提供了完整、可本地部署的开源实现。
在细化模型训练过程中,研究团队冻结了 H3 Transformer 主干网络与视频 VAE 的全部原始参数,仅对新增的细化 LoRA 模块进行微调。推理阶段,该 LoRA 与 LightX2V FL2VA Turbo、LMS Sharp 等社区主流适配器协同工作,通过三阶段去噪流程,在目标分辨率下逐层恢复画面细节。原始视频草稿中所蕴含的场景结构、空间布局与运动轨迹,则作为整个细化过程的关键先验信息。
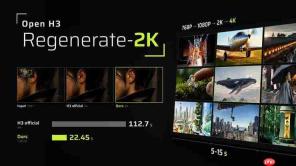
为提升端到端推理效率,项目集成社区开发的潜空间放大器(Latent Upscaler),直接对视频潜在表示进行上采样,避免高分辨率下反复编解码带来的计算冗余。同时,方案深度融合 SoL-Engine 所提供的稀疏注意力机制、低精度张量运算以及高速 VAE 解码器,在细化建模与最终解码两个关键环节实现显著加速。
据项目团队公布的基准测试结果:在单张 NVIDIA B200 GPU(已完成预热)环境下,一段约 5 秒长视频完成潜空间放大、三步细化及 2K 解码全流程的总耗时,由未优化版本的 87.26 秒大幅压缩至 22.45 秒,整体处理速度提升至原来的约 3.9 倍。其中,快速解码器单独将视频解码阶段耗时从约 15 秒降低至约 1.6 秒。
在画质表现方面,团队在 RefinerBench-150 数据集上开展了系统性对比评测。在统一输入与相同 2K 输出条件下,Open-H3-Regenerate-2K 在感知质量评估指标 UniPercept 上取得平均分 60.0,优于官方 H3-Regenerate-2K API 的 53.4 分;VBench 综合评测显示,该方案在美学质量、成像保真度与主体一致性三项指标上均领先,而官方 API 在运动连贯性与动态丰富度方面仍保持小幅优势。
MiniMax H3 于今年 8 月全面开放模型权重,迅速引发全球范围内的技术响应——围绕 H3 的微调、知识蒸馏、工具链适配等工作呈爆发式增长,吸引了大量海内外科研团队与开源开发者参与共建。上线一个月内,H3 模型在 Hugging Face 的下载量突破 2400 万次,衍生出超 300 个公开可访问的下游模型,稳居 2026 年全球下载量最高的开源模型行列之一。
值得一提的是,英伟达与 MIT 合作团队围绕 H3 的技术拓展覆盖多个前沿方向。除本次发布的视频增强方案外,该团队还推出了基于 H3 Ref2VA 构建的流式视频渲染模型 StreamRender-H3,以及从 H3 视频 VAE 蒸馏而来的轻量级解码器 Sol-H3-VAE,分别面向实时交互式视频生成与极致解码效率优化两大应用场景。
此前,LightX2V 推出的 MiniMax-H3 Turbo 提供四步、八步等多种蒸馏步数版本;社区热门微调模型 Singularity 则聚焦动作自然性、面部刻画精度与视觉风格一致性提升。海外团队 FastVideo 与 Pika 亦相继发布 FastH3(四步预览版)与 Pika H3 Flex(六步采样版);ComfyUI 与 Unsloth 等生态工具则通过权重适配与量化支持,进一步推动 H3 融入多样化本地创作流程。


