k-中心点算法和k-means在基本思想上较为接近,但关键差异在于:k-means使用每类中所有样本的均值作为聚类中心,而k-中心点则从当前类别所含的实际观测点中选取一个样本——该样本到同类别内其余所有样本的距离之和最小——作为代表中心(即中心点)。
1、 导入原始数据集
2、 执行聚类建模过程。
3、 载入cluster扩展包,为后续聚类运算提供支持。
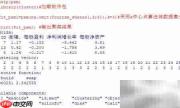
4、 对已清除缺失值的Tourism_shares数据集应用k中心点法,指定聚类簇数为3,生成模型对象fit_pam1。
5、 展示聚类结果摘要,输出fit_pam1中各观测所属类别信息。
6、 输出结果中的Medoids字段标识出每个簇对应的中心点在原始数据中的行号(即具体样本索引)。
7、 提取并保存每个观测点被划分到的簇标签。
8、 浏览旅游份额数据集的头部若干条记录。
9、 将本方法所得结果与K-means聚类结果对比,可发现部分样本在两种算法下的归属类别并不一致。
10、 绘制二维散点图以可视化聚类效果。