





小米正式发布空间音频理解大模型 midashenglm-spatial,全面开源模型权重与推理代码,并以 apache 2.0 开源许可证授权。官方指出,该模型是全球首个面向公众开放的端到端空间音频理解大模型,在传统音频理解能力基础上,首次系统性集成了空间感知与空间推理能力。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
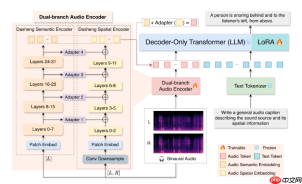
过去两年间,小米已陆续开源声音基础模型 Xiaomi Dasheng 与声音理解大模型 MiDashengLM-7B,相关技术已在智能家居、智能汽车座舱等实际场景中落地应用超30个案例,实现对语音、环境音及音乐内容的统一建模与深度理解。
本次推出的 MiDashengLM-Spatial 基于 MiDashengLM-7B 进行深度升级,不仅可准确识别音频语义内容,更能精准定位声源方位、判断多声源的空间布局关系,标志着音频大模型正由单一内容理解迈向具备三维空间听觉能力的新阶段。

将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
小米强调,MiDashengLM-Spatial 将逐步部署至智能家居、车载交互等核心场景,依托空间听觉能力持续优化「人车家全生态」下的自然交互体验。同步开放的模型权重与推理代码,也将为学术界与工业界开展空间音频理解方向的研究与创新应用提供关键基础设施支持。当前相关基准测试数据仍在持续完善中。
项目主页:https://www.php.cn/link/3e3d55f06a5134a65966a32da7a3b6a7







