





ai时代最关键的是什么?有人坚信无疑是算力,但真正可持续、可落地的算力输出,根本上依赖于卓越的功耗管理能力。2026年,智能体ai正加速推动手机演进为一台全天候、全场景运行的本地化计算终端——语音理解、图像识别、多模态推理、复杂任务编排,皆在设备端实时完成。用户每一次语音或手势指令背后,往往牵动十余个子任务的并行调度与协同响应。倘若芯片功耗控制乏力,再惊艳的ai参数也只是纸上谈兵——实测中依旧发热严重、频率骤降、续航断崖式下滑。
高通即将推出的全新旗舰平台,堪称在AI性能与能效平衡上实现了突破性统一。尽管芯片正式亮相要等到9月22日的骁龙峰会,但自8月下旬起,高通官方博客已密集释放多项核心技术细节,让业界提前一窥其技术轮廓。从8月25日至9月2日,CPU与GPU两大专题博文接连上线,共同指向一个明确趋势:骁龙新一代旗舰正将功耗从传统意义上的“限制项”,升维为差异化竞争的“核心资产”。
 2nm:功耗优化的物理基石
关于新旗舰的制程工艺,虽未由高通直接官宣,但来自晶圆代工、封测及设计链路多方信源已高度一致:全系搭载N2P(2nm增强型)先进制程,这也是高通首款采用2nm工艺的移动SoC。相较前代3nm节点,晶体管密度提升30%,相同性能下功耗降低36%,同等功耗下性能提升18%。
高达36%的功耗下降幅度,意味着困扰旗舰机型多年的高负载发热与续航焦虑,首次具备了从半导体物理层面被系统性缓解的基础条件。近年来芯片性能跃升愈发依赖“拉高主频”,然而频率每提升一小步,功耗却呈非线性飙升。2nm工艺则从根本上拓展了能效边界,为AI长时稳定运行筑牢底座。
CPU:比5GHz更值得铭记的,是44%的能效跃升
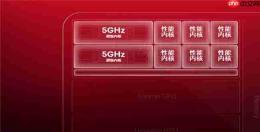
5GHz是CPU专题博文中最吸睛的数据——全新Oryon CPU架构成为全球首个突破该频率门槛的移动处理器。但高通特别指出,达成5GHz并非单靠先进制程即可实现,而是深度定制化微架构设计的综合成果。每个CPU核心均配备独立时钟域,支持按需动态调频——“用多少,供多少”,杜绝无效供电。
与此同时,FlexCache技术将L2缓存重构为全核心共享资源池,高频访问数据可常驻缓存,大幅减少对系统内存的调用次数——每一次内存读写规避,都对应一次实打实的能耗节省。
 GPU:AI如何反向驱动功耗下降
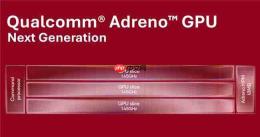
GPU技术博文释放的信息更具颠覆性:新一代Adreno GPU运行频率由1.2GHz跃升至1.45GHz,表面看易引发功耗担忧。但高通早已布好全局能效棋局。
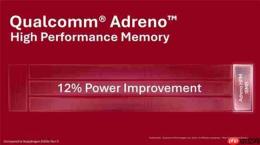
18MB Adreno HPM片上高速显存,使图形渲染过程中的中间帧数据全程驻留于芯片内部,彻底规避频繁往返系统内存,带来约12%的功耗优化。Adreno Matrix Cores——GPU首次集成的AI专用矩阵计算单元,让神经网络推理无缝嵌入图形管线,数据路径每缩短一环,就减少一分能耗损耗。Adreno Neural Fusion技术则将AI超分与帧生成深度耦合进渲染流程,相较上一代方案,最高可降低40%相关功耗。
 功耗,正成为衡量AI时代竞争力的新标尺
过去评价一颗芯片优劣,跑分是硬通货;而迈入智能体时代,用户真正需要的不再是转瞬即逝的峰值性能,而是持续、可靠、无感的AI交互体验。唯有功耗管控足够精细,AI能力才能真正融入日常,而非沦为实验室里的演示项目。
高通此代芯片的本质跃迁在于:它不再将功耗视为亟待掩盖的短板,而是将其锻造为支撑AI能力持续释放的核心优势。从2nm制程带来的物理级能效红利,到Oryon CPU的独立时钟域与FlexCache架构,再到Adreno GPU的HPM显存、Matrix Cores与Neural Fusion引擎——每一项关键技术迭代的背后,都精准锚定一组关键能效指标:36%、12%、40%。这些数字叠加形成的能效合力,最终决定了单位功耗下所能承载的AI算力密度。当我们关注芯片算力有多强的同时,更应追问:在功耗红线约束下,它究竟能稳定输出多久?



