





9月17日,在华为全联接大会2026举办期间,华为常务董事、ict bg ceo杨超斌发表主旨演讲,聚焦计算架构演进,全面解读灵衢互联架构,并正式推出基于该架构的系列化算力基础设施,持续强化生态协同能力,赋能客户、合作伙伴及开发者开展应用创新。
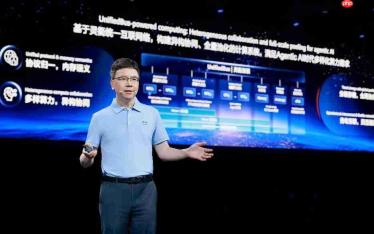
华为常务董事、ICT BG CEO杨超斌发表主题演讲
在传统计算范式下,随着集群规模扩大,整体资源利用效率不升反降——典型十万卡集群中,大模型实际算力利用率仅为约20%,大量计算单元长期处于通信等待状态。面对10T参数级大模型训练任务,中间激活数据体量激增,单张GPU显存已难以承载;与此同时,Agent与模型每小时交互频次可达数百次,要求CPU与NPU算力动态按需调配、高效协同,由此产生的KV Cache规模远超本地内存容量,亟需跨设备、跨层级的统一存储支撑。在此背景下,系统内各部件间的互联带宽、时延与协议一致性,已成为制约整机性能跃升的核心瓶颈。
为此,华为以灵衢互联为技术支点,构建“超节点+集群”协同演进的新一代计算体系,全面适配Agentic AI时代爆发式增长的算力需求。依托灵衢架构的新型计算系统,具备以下四大核心能力:
一、协议统一,内存语义化访问。整合十余种异构互联协议,统一为高带宽、低时延的灵衢协议栈;互联吞吐由百GB级跃升至TB级,端到端RTT时延从7微秒压缩至2微秒,支持超节点内全域内存统一寻址与一致访问。
二、多元算力,异构无感协同。CPU、NPU、内存、SSD等关键组件通过灵衢直连,实现去中心化平等互访;CPU与NPU资源可按业务负载灵活配比;借助分层分级Transformer硬件加速引擎,将Attention与FFN模块解耦,支持AF分离部署与弹性调度。
三、分级存储,资源全局池化。采用混合介质统一资源池架构,释放DDR作为NPU“扩展内存”,显著降低搜推广类业务响应延迟;千亿级、数千维向量检索性能提升一倍;大幅缓解10T大模型训练对单卡HBM容量的依赖,有效提升集群MFU(Model FLOPs Utilization)指标。
四、光电融合,组网高度灵活。打造覆盖全栈的超高带宽、超低时延“数据高速通道”,支撑从小规模单柜到超大规模集群的按需弹性扩展。
本次大会上,华为同步发布分层演进的灵衢互联硬件产品线,完整覆盖柜内互联、跨柜互联与集群级互联三大层级,全面支持从单柜部署到百万卡级超大规模集群的平滑演进。其中,柜内灵衢互联刀片实现全光无缆化设计,零铜缆、零电路损耗,单个4096卡超节点可节省高达196公里铜缆;跨柜灵衢互联设备单机支持176端口,单端口速率高达1.6T,整机全光互联带宽达280T,是当前业界端口密度最高、单机带宽最大的高速总线协议互联设备,RTT稳定控制在2微秒以内;UBG灵衢网络交换机具备1024 Radix超大扇出能力,可高效支撑百万卡级超节点集群建设,满足未来模型参数向数十万亿规模持续演进的技术诉求。
此外,华为正式发布面向Agentic AI场景的灵衢超节点集群解决方案,由鲲鹏950处理器、昇腾960 AI芯片、OceanStor M900记忆型存储系统及星河UBG交换机构成,实现多类型算力深度融合与分级资源统一调度。
灵衢互联能力不仅服务于超大规模集群,亦深度融入一体机产品体系。华为基于灵衢架构推出覆盖1卡至8卡的系列化AI一体机及鲲鹏+昇腾融合模组。例如,Atlas 650E风冷服务器通过双机灵衢直连,实现16颗NPU免交换芯片级互联,两台物理设备可像单一逻辑节点协同运行,支持无缝扩容,构建轻量级超节点,助力中小企业在本地环境高效运行万亿参数大模型。
在生态共建方面,昇腾平台已与DeepSeek Harness、OpenCode、openJiuwen等主流开源框架完成深度集成,联合推出涵盖智能调度、推理优化、可信安全等能力的Agent插件化组件,并全部开源;目前已携手50余家行业客户、合作伙伴及高校,共建26个垂直领域专用算子库;同时与90余个国际主流开源社区建立合作,加速行业Agent开发进程与企业IT系统对接落地。
在AI驱动千行万业智能化升级的大趋势下,算力正成为数字化转型的关键底座。杨超斌强调:“华为将持续坚持系统级技术创新路径,打造多样化、可演进的算力基础设施体系,秉持开源开放原则,携手客户、伙伴与广大开发者共建繁荣生态,为全球智能化发展提供更优选择。”
2026年9月17日至19日,华为全联接大会2026于上海世博展览馆与世博中心隆重举行。本届大会以“智启新未来”为年度主题,从“战略全景—产业技术—生态发展”三大维度,系统呈现华为全面智能化战略的最新实践成果,集中发布前沿技术产品与解决方案、标杆性行业智能化应用案例、以及易用高效的开发者工具链与平台体系。更多资讯,请访问华为全联接大会官网:www.huawei.com/cn/events/huaweiconnect


