





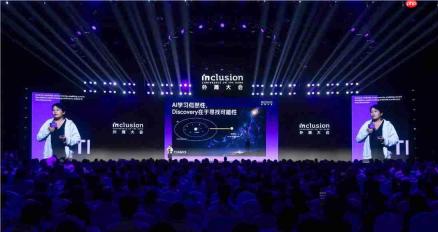
9月10日,在2026 inclusion·外滩大会主论坛上,普林斯顿大学人工智能创新中心主任王梦迪教授抛出一个关键命题:ai距离真正实现自主科学发现,究竟还有多远?
她的观点直指当前大模型能力的本质边界:尽管如今的模型已吸纳海量人类知识,但在催生原创性科学突破方面仍显乏力。核心症结在于——大模型本质上是“众数捕手”,精于输出概率分布中最大似然(Mode)的答案;而颠覆性的新发现,往往蛰伏于长尾区域——那些低频、异常、非典型却蕴含本质规律的边缘情形。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
为验证这一判断,王梦迪团队联合普林斯顿社会学系谢宇教授开展了一项跨学科实验:调用ChatGPT、Claude等主流大模型,执行“模拟人生”任务——设定身份为1930年出生的英国人,自主推演其教育路径、职业选择、婚育时间等生命历程。
结果清晰呈现系统性偏差:在“首次结婚年龄”等维度,模型高度集中于24岁左右这一常见值,严重弱化了真实社会中广泛存在的早婚、晚婚、不婚等长尾现实;在职业与性别分布上亦复现类似倾向——模型不断复刻“最标准”的叙事,却对多样性与偶然性视而不见。

“它学会了分布的峰值,却遗忘了尾巴。”王梦迪指出,“这正是大模型在数学证明与代码生成中势如破竹,却迟迟未能撬动物理定律重构、化学反应机制革新或生物通路重写的根本原因。”
根本差异在于可验证性。编程有编译器与单元测试,数学有Lean等形式化验证工具,构成闭环反馈——试错—修正的学习飞轮。而真实科研世界缺乏这种即时、客观、可重复的“验证器”:实验依赖精密仪器与人工判读,结论常需多团队交叉复现,许多现象本身即具不可逆性与情境敏感性。“想法很廉价,我要看的是代码,或是实验。”她强调,当信息爆炸稀释信噪比,当假设难以被干净证伪,AI便困于“已知的舒适区”,无法向未知的长尾纵深探索。
因此,王梦迪主张:通往AI自主发现的钥匙,不在堆叠参数或扩充语料,而在于重塑物理世界的“可计算接口”。其团队正双轨推进基础设施建设:一是在量子材料方向部署全自动石墨烯实验平台,将耗时数月的人工流程转化为API可调用的标准化服务;二是研发面向实验室的智能操作系统LabOS——融合智能眼镜视觉感知、自然语言指令理解、机器人执行控制与AI推理引擎,使AI能“看见”实验现场、“听懂”科研意图、“操作”真实设备、“记录”完整过程。
在她看来,决定AI能否跃升为“科学发现者”的终极变量,不是算力规模,而是是否存在一套贯通“提出假设—设计验证—追溯过程—重复实验”的数字-物理耦合基座。唯有当现实世界被系统性地编码为可记录、可审计、可再生的数字孪生体,AI才可能挣脱“似然性”的引力束缚,真正开启对“可能性”的主动勘探。


