





Model Fusion 早期靠“免费提分”吸引了不少用户关注,但当产品开始转向付费后,市场反馈明显变弱,也让外界重新思考:这类能力到底是不是用户真正愿意长期买单的需求。很多用户已经习惯了免费服务,一旦进入付费阶段,转化率往往低于预期,这也暴露出它在商业化上的现实难题。
这并不是个别产品才会遇到的问题。放在更大的 AI 工具行业里看,从“先把流量做起来”到“真正形成收入”,中间本来就有一道不小的门槛。问题不只是产品能不能把分数做高,而是用户是否愿意持续为这部分提升支付费用。
一、Model Fusion 是什么?先弄清它到底在做什么
2026 年 6 月,不到三周时间里,AI 市场接连出现了两款都叫“Fusion”的产品。
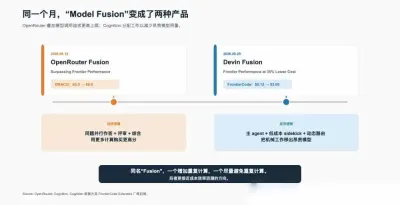
6 月 12 日,OpenRouter 发布了 Fusion Router,并用“Surpassing Frontier Performance with Fusion”来介绍这项能力。按照其 DRACO 深度研究评测,Fable 5 与 GPT-5.5 组成的模型组合得到 69.0 分,高于 Fable 5 单模型的 65.3 分。它的思路并不复杂:如果单个模型回答得不够理想,那就让多个模型同时回答同一个问题,再由评审模型进行比较、汇总,最后给出结果。
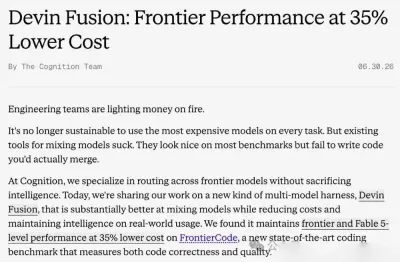
6 月 29 日,Cognition 发布 Devin Fusion,标题是“Frontier Performance at 35% Lower Cost”。它的做法和前者不同。Devin Fusion 不是让多个模型把同一件事完整做一遍,而是把规划、判断这类更关键的环节交给前沿模型,把测试、机械修改等成本更低、可重复的部分交给 sidekick,并在执行过程中动态切换模型。
两者都叫“Fusion”,但背后的逻辑其实差别很大。OpenRouter 更像是“多花算力,换更高上限”;Cognition 更像是“尽量守住质量,同时把高成本调用降下来”。相比只看模型排行榜,这种差异更能说明市场真正关心的是什么。
从技术上说,模型融合并不是没有价值。多个模型反复尝试、给出多个候选答案,确实有可能比只问一次更好。但市场真正愿意付费的,不是“我调用了多少模型”,而是结果能不能达标,以及能否在成本、延迟和稳定性上保持可接受。
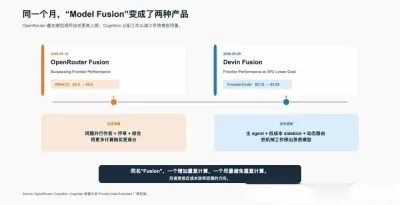
▲ 图 1:同一个月,两种 Fusion
本文所说的 Model Fusion,采用更狭义的定义:多个模型围绕同一任务并行作答,再由评审模型比较结果,最终由一个模型输出答案。按这个标准看,Devin Fusion 更接近动态路由和任务委派,并不属于狭义的模型融合。
之所以要先区分清楚,是因为现在市场上越来越容易把“Fusion”当成一切多模型编排方式的统称。但从效率角度看,真正更贴近生产需求的产品路线,很多时候已经开始偏离狭义的 Model Fusion。
整体来看,Model Fusion 更像是一种成本偏高的“质量保险”。它在某些任务上确实能提升表现,但很少能把“成本—质量—延迟”这三者的综合效率一起推到更优位置。所以,真正愿意长期为这份“保险”付费的场景并不多。它大概率会一直存在,但更可能是一项低频功能,而不是默认架构,也不太容易发展成独立的大品类。
二、Model Fusion 到底值不值?先看模型选择和成本效率
很多人在讨论 Fusion 时,容易只盯着准确率或者榜单分数,但企业采购模型时并不是在买“排行榜名次”。真正被采购的是任务结果能不能过线,同时还要兼顾价格、响应速度、隐私和稳定性。只要便宜的模型已经能满足业务要求,继续为“更聪明一点”支付更高溢价,未必就划算。
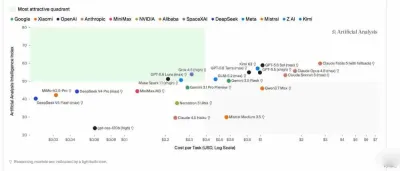
▲ 图 2:模型智能与单任务成本,横轴为对数刻度
所以,图里真正值得关注的,不一定是右上角分数最高的模型,而是那些偏离价格—能力趋势线的点。简单理解,就是它们能用更低的价格,提供“已经够用”的能力。这类模型未必在所有任务里都最强,但在一些具体工作负载下,反而更有性价比。综合指数无法直接告诉你某个模型是否适合代码审查、中文研究或者受监管场景部署,但它至少说明了一件事:模型供给正在越来越商品化,“最强模型”和“最优选择”已经不是一回事。
围绕同一个质量缺口,当前市场大致有四种常见做法:
- 直接升级到更强的单模型。这种方式最简单,也更容易审计。如果高端模型的额外成本低于错误和返工带来的损失,它通常仍然是第一选择。
- 在同一个模型上增加测试时计算,比如延长推理、self-consistency 或多次采样。
- 使用路由、级联和任务委派机制,让低成本模型先处理机械性或可验证的部分,遇到难题再升级。
- 采用狭义的 Model Fusion,也就是多个模型围绕同一个问题重复作答,再让评审和综合模型产出最终结果。
这四类方案本质上都在做同一件事:用更多计算换更高质量。区别只在于,额外的预算究竟花在了哪里。单模型扩展买的是更深的推理,路由买的是更精准的资源分配,而 Fusion 买的是更多候选答案。
前面三种方式,通常会把预算集中到更可能影响结果的地方;而 Fusion 则是先为“多份答案”付费,再希望评审模型能从这些答案里找出真正更优的部分。只有当候选模型确实带来了足够独立的信息,同时评审模型也确实有能力识别这些差异时,Fusion 才可能优于其他路径。
路由机制已经说明,模型间的能力差异,本身就是一种调度机会。RouteLLM 在部分评测中实现了超过 2 倍的成本下降且不损失质量;Switchcraft 以 82.9% 的准确率换来 84% 的成本下降,按论文测算,每百万次请求可节省超过 3,600 美元。虽然这些结果还需要在真实企业流量中进一步验证,但它们体现的经济逻辑很清楚:很多时候,不一定要让多个模型“开会”,只要把任务交给最便宜且合格的模型,就已经足够。
这也意味着,市场通常会先尝试升级单模型、路由和验证机制来补足质量缺口;只有这些办法还不够时,才会考虑为 Fusion 额外支付成本。
三、为什么 Model Fusion 能提分,却不一定有实际价值?
原因在于,Fusion 要真正成立,至少要同时跨过三道门槛:第一,增加的质量是否能覆盖新增的成本与延迟;第二,不同模型是否真的带来了独立信息;第三,评审系统是否能稳定挑出更好的答案。只要这三点里有任何一点不成立,评测里的提分就很难变成真实生产价值。
1. 计算成本怎么理解?Fusion 要多花多少钱、慢多少
Fusion 首先是一笔很直接的计算开销。OpenRouter 的方案需要并行调用多个 panel 模型,再由评审与综合模型给出结果。按照其 DRACO 的三组对照数据,Fusion 确实都带来了提分:Fable 5 + GPT-5.5 从 65.3 提升到 69.0;Opus 4.8 自融合从 58.8 提升到 65.5;低成本三模型组合从 60.3 提升到 64.7。
但需要注意的是,Opus 自融合的提升幅度反而更大,这说明收益未必主要来自跨模型之间的知识互补,也可能更多来自额外的搜索和采样。如果要更公平比较,应该放在同样的 token 预算下,看 self-consistency、更长推理或者更强单模型是否也能达到类似效果。
已有研究也给出了相近信号:多智能体在约 20 倍计算量下,最多提升 7.1 个百分点;在相同预算下,debate 与 Mixture-of-Agents 只比 self-consistency 高 1.3 和 2.7 个百分点,另一项等 reasoning-token 研究甚至发现单 agent 持平或更优。也就是说,很多看起来很亮眼的“协作收益”,一旦把计算账认真算清楚,提升幅度往往会明显缩小。
▲ 图 3:OpenRouter 的基准提升与产品成本
OpenRouter 默认 3 模型 panel 的成本大约是普通生成的4 至 5 倍,速度慢 2 至 3 倍。但它并没有披露各 DRACO 配置对应的完整 token、成本和延迟数据,因此外界还无法准确判断,这 3.7 分提升到底值不值。同时,该评测只覆盖 100 个纯文本英文任务,Fable 相关配置只完成了其中 93 项;如果换一个评审模型,绝对分数还可能偏移 10 至 25 个百分点。这些结果可以证明 Fusion 能提分,但还不足以证明它改善了真实生产环境里的投入产出比。
即便采用“只在少数场景触发”的选择性调用,也只能在一定程度上摊薄成本。按 OpenRouter 披露的区间估算,触发率为 1% 时,整体成本约为 1.03 至 1.04 倍;触发率为 10% 时,升到 1.30 至 1.40 倍;触发率达到 25% 时,则已经接近 1.75 至 2.00 倍。
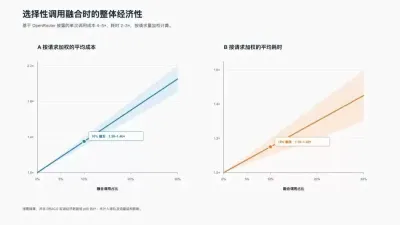
▲ 图 4:选择性调用 Fusion 的整体经济性
更现实的一点是,最难的请求往往最容易触发 Fusion,而系统又必须等待最慢的 panel 成员返回,再继续做评审和最终生成。因此,最关键的问题反而最容易遇到尾部延迟。再加上多供应商调用会扩大故障面,提高审计复杂度,也可能增加隐私暴露风险,所以Fusion 的成本不仅是 API 账单,还包括等待时间和系统复杂度带来的额外风险。
2. 信息互补真的存在吗?多个模型不一定等于更多独立答案
Fusion 成立的一个核心前提是:多个候选模型能够带来彼此独立的信息。但现实里,不同模型往往共享训练语料、网页来源,甚至会沿着相似的错误前提推理。在研究型任务中,这很容易出现所谓的“引用洗白”——表面看有好几份独立证据,实际上可能都来自同一个源头。
如果系统不能保留 claim-level provenance 和搜索路径,那么随着模型数量增加,API 成本几乎是线性上升的,但证据多样性却不一定同步增加。
KAIKAKU.AI 联合创始人兼 CEO Josef Chen 在 2026 年论文《When Does Combining Language Models Help?》中研究了 21 家服务商的 67 个模型。结果显示,在开放式数学任务中,所有模型同时答错的理论预测概率为 2.3%,但实测达到5.2%,约为预测值的 2.3 倍;在执行评分代码任务和自由回答版 GPQA-Diamond 中,共同失败率进一步升到7.9% 和 12.7%。
如果换算成 100 道 GPQA-Diamond 题目,大约会有 13 道题是所有候选模型一起答错。这样一来,不管是投票、评审还是综合,都没有正确答案可供筛选。模型在容易题上的分歧,可能会放大组合价值;但在真正需要“保险”的难题上,它们反而可能集体失手。
3. 评审真的可靠吗?系统不一定总能选出最好答案
即便候选答案之间确实存在互补,最终价值仍然取决于评审系统本身。候选答案高度一致时,评审模型可能把“大家都这么说”误当成高置信度结论;而当候选答案彼此分歧很大时,评审模型又必须足够专业,才有能力识别谁更优。与此同时,综合模型还有可能抹掉关键的少数意见,或者把真实分歧改写成表面统一的确定性结论。
在代码任务里,编译器、测试体系和静态分析工具,往往比“再听一个模型的意见”更可靠;而在创意任务里,评审与综合又容易把差异压平成平均答案。LitBench 的结果显示,最强的现成评审模型与人类创意写作偏好的一致率也只有73%。这意味着,如果任务本身已经有便宜的外部验证器,或者“好不好”本来就带有较强主观性,那么 Fusion 的提分往往很难变成明确、稳定、可付费的价值。
四、Model Fusion 有没有真实市场需求?谁可能为它付费
Fusion 是否存在真实需求,关键要看两道门槛。第一,这类任务本身能不能从多模型协同中受益;第二,这种收益能不能支撑持续付费。前者是技术适用性问题,后者才是市场问题。
1. 从技术上能用,到经济上成立,中间还差什么
Fusion 能不能成立,取决于“把错误纠正过来的概率 × 单次错误可避免的损失”,是否大于新增的 API 成本、延迟、运维复杂度和隐私风险。
单看基准测试分数,其实回答不了这道账。Fusion 只有在几项条件同时出现时,才更可能具备经济意义:错误代价足够高、候选模型确实能提供互补搜索路径、没有更便宜的外部验证器,而且业务还能接受额外延迟和供应商风险。即便如此,最终结果通常仍需要人工或外部证据来确认。
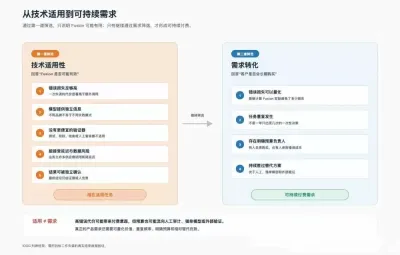
▲ 图 5:从技术适用到可持续需求
更符合这些条件的场景,通常包括高价值研究与尽调、架构与安全评审,以及不可逆决策前的“第二意见”。这些任务的共同点是:约束条件不完整、遗漏代价高,而且多一条独立思路本身就有价值。
相对来说,常规代码任务、实时消费级应用、高吞吐低毛利工作流,以及那些本来就能通过测试或规则直接验证的任务,通常并不需要 Fusion。在受监管行业里,多供应商 panel 还可能因为数据边界和审计要求,根本不被接受。
2. 技术上有用,不等于一定能做成持续付费市场
一个能力在技术上有效,并不代表它一定能形成规模化付费需求。如果要变成可持续市场,通常还需要同时满足几件事:错误损失可以量化、任务会反复发生、组织内部有明确预算负责人,而且 Fusion 长期看仍然要持续优于人工专家、强单模型和外部验证方案。
但现实里,尽调预算往往更愿意流向分析师和可信信息源,安全预算也更倾向投给专业审计,而所谓“不可逆决策”本身发生频率并不高。
因此,那些只做多模型 wrapper、默认运行 panel,或者把静态模型选择算法当作主要护城河的公司,前景很难让人过度乐观。连接 API 的能力本身较容易复制,固定策略也会随着模型价格和能力变化迅速失效。如果不能明确知道一次错误到底值多少钱,也无法衡量 Fusion 实际纠正了多少错误,那么这份“保险”就很难被准确地定价。
更有机会捕获价值的,反而是掌握真实结果和任务上下文的一方,比如网关与 agent 平台、垂直应用、工作流所有者,以及评测和可观测性产品。它们知道错误成本,能看到任务结果,也更有机会优化触发策略。真正难复制的,不是 panel 里接了哪些模型,而是能否准确判断什么时候根本不该调用 Fusion。
3. 现阶段市场上,Fusion 主要是怎么被用的
从公开市场信息来看,现在还很难判断 Fusion 的总体需求到底有多大,但已经能看出它主要是怎么被使用的。Perplexity 的 Model Council 只向每月 200 美元的 Max 用户和 Enterprise Max 用户开放,用户可以在网页端手动选择三个模型,用于投资研究、复杂决策和信息验证;公开案例里,也有人把 Model Council 接入股票研究流程的 browser automation。
Hermes Mixture of Agents 则把 Fusion 设计成 agent 体系里的可选虚拟模型:用户既可以通过 /moa 只在某个困难问题上临时升级,也可以在复杂 session 中持续开启,让多个 reference models 提供分析,再由 aggregator 调用工具完成任务。后续 Hermes 还降低了默认 fan-out 频率,并复用上一轮模型意见来控制成本。
这些案例说明,Fusion 的实际需求更集中在 research、debugging、review 和重要决策等低频高难任务里。它更像是单模型遇到瓶颈后的主动升级,而不是默认开启的高频自动化流程。现有公开证据足以说明这类需求确实存在,但还不足以证明它已经形成一个独立且规模化的付费市场。
五、Fusion 的未来会怎样?它会成为主流架构吗
推理价格下降,表面上看似乎有利于 Fusion,但别忘了,这也会同时降低强单模型、路由方案和外部验证工具的成本。Fusion 面对的竞争对象,不是昨天那次普通模型调用,而是不断进化的下一代单模型和编排基线。
Cognition 的 Devin Fusion 已经展示出一种更接近生产经济学的方向:把昂贵模型留给判断环节,把可验证、机械性的工作交给更便宜的模型执行。根据其自测数据,Fusion + Fable 5 的总分从 57.0 小幅升到 57.6,平均成本则从 5.12 美元降到 3.00 美元;但在公开的 5 个案例里,虽然成本都下降了 25% 至 62%,任务得分却在 +12 到 -27 之间明显波动。
其中,边界清晰、测试充分的 ES6 重构任务,从 98 分提升到 100 分;而依赖交互理解和隐含需求判断的 React/Redux 功能,在错误委派后则从 54 分降到 27 分。
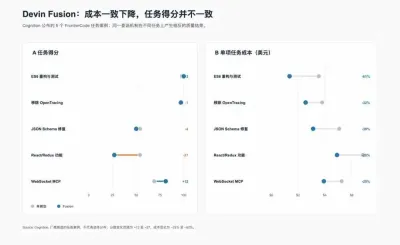
▲ 图 6:Devin Fusion 的任务得分与成本
这些案例由厂商自行挑选,不能代表整体分布,但它们至少指向了一个更关键的判断:未来多模型系统的核心能力,不是“调用更多模型”,而是“划对降级边界”。可验证、机械性的任务可以交给低成本模型;而判断密集、依赖上下文理解的任务,仍然必须交给前沿模型处理。
OpenRouter 卖的是“更多智能”,Cognition 卖的是“接近的智能,更低的成本”。从长期看,后者显然更贴近市场方向。一个系统越接近真实生产经济学,它就越不像狭义的 Model Fusion,反而越像路由、委派和验证的组合。
7 月下旬,有媒体报道称 Stripe 正洽谈以约 100 亿美元收购 OpenRouter,但相关交易尚未确认。即便这一消息成立,也不能简单理解成 Fusion 已经完成了市场验证。OpenRouter 的核心价值并不在某一个 panel 产品,而在于它作为中立调用层,连接了超过 500 万开发者和 400 多个模型。Stripe 已经为其提供计费、税务和风控支持,并允许开发者通过 Stripe Projects 直接创建账户、获取 API key 和接通付款。
如果 Stripe 真正看重 OpenRouter,更可能是在看重 AI 推理时代的交易入口。OpenRouter 掌握模型选择、token 使用和成本数据,Stripe 负责定价、账单与支付。这也对应前文的判断:在多模型时代,价值更可能留在能观察任务、分配调用并完成结算的 orchestration layer,而 Fusion 只是其中一种成本较高的升级策略。
未来的多模型系统,大概率不会默认拉起 panel,而是先评估任务难度、验证成本和错误损失;只有当更强单模型、延长推理和外部工具都不能满足需求时,才会进入多模型分歧搜索阶段。真正更有意义的产品指标,也会是触发率、增量成功率,以及经验证的单位结果成本。因此,Fusion 更可能长期作为一种低频功能存在,而不是成为默认架构或独立品类。
需要说明的是,本文讨论的是产品路径、成本结构和商业化逻辑,不构成任何投资建议。无论是 AI 工具、模型平台还是相关概念产品,市场需求和付费意愿都存在不确定性,实际落地仍需结合具体场景评估,并注意相关风险。
六、来源
- OpenRouter:用 Fusion 超越 Frontier 性能
- OpenRouter Fusion Router 文档
- Cognition:Devin Fusion——以 35% 成本降低实现前沿性能
- Microsoft Research:Switchcraft——用于代理工具调用的 AI 模型路由器
- When Does Combining Language Models Help?
- 多智能体推理提升计算效率
- 单智能体大型语言模型在多跳推理中,在相同思维令牌预算下优于多智能体系统
- 代理混合增强了大型语言模型的能力
- RouteLLM:学习如何用偏好数据对 LLM 进行路由
- LitBench:创意写作评估基准
- 人工分析模型比较
- 进步的代价:价格表现与人工智能的未来
- Perplexity:什么是 Model Council
- Perplexity 用户示例:金融研究中的 Model Council
- Hermes Agents:Mixture of Agents 文档
- Stripe 支持 OpenRouter 的全球 AI 模型访问
- Axios:关于 Stripe 与 OpenRouter 报道背后的原因





