





excel 里做复杂查找,卡壳的往往不是写不出公式,是条件太杂:既要按地区、产品先筛一遍,又要从剩下的结果里挑指定字段,还得避免跳出一堆无关数据。这时候别死磕把xlookup写得老长,先拿filter把候选范围收窄,再用xlookup从筛选后的结果里找目标值,整个公式逻辑会清爽很多。
这个搭配完全适配「先筛范围、后做查找」的需求:比如只在某一地区的订单池里查对应客户,只在金额超过阈值的记录里找负责人,只在指定季度的数据里搜某款产品的价格。整体思路拆成两步走就行:FILTER 先把符合前置条件的行都圈出来,剩下的精准取值全交给XLOOKUP。
先确认 XLOOKUP 要找什么、返回什么
先把最基础的XLOOKUP逻辑捋顺。它一共就三个核心参数:找什么值、在哪列找、最后返回哪列的内容。举个例子,要根据输入的国家名查对应电话区号,就是用输入单元格的内容匹配国家名称列,再从区号列把对应值调出来。
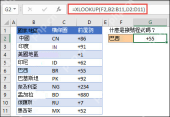
就算做复杂查找也别一上来就硬拼嵌套公式。先理清楚三件事:你要找的目标值存在哪个单元格、要和哪一列做匹配、最后想拿到哪一列的结果。这三点先敲定,后面加FILTER的时候根本不会乱。
用 FILTER 先筛出符合条件的候选记录
数据表有多重前置条件的时候,先拿FILTER把候选行筛出来。比如要只留下销售额大于10000、且所属国家是USA的记录,直接把多个条件用乘号连起来,传给FILTER的include参数就行。最后出来的不是单个单元格,是一片自动扩展的动态结果区域。
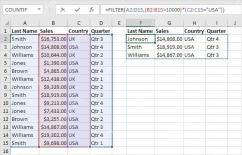
这里要记牢:FILTER不用直接出最终答案,它的任务就是先把所有可能符合要求的行挑出来。相当于你先把一大堆文件按部门、日期筛一遍,剩下一小摞之后再慢慢找具体的负责人。
观察 FILTER 的溢出区域是否干净
FILTER输出的结果会自动向右、向下溢出铺满区域。在嵌套XLOOKUP之前,先检查这片结果区有没有多余空行、列错位,或者是不是条件写反了筛出来不对的内容。这一步要是筛错了,后面XLOOKUP逻辑再准,拿到的结果也肯定不对。
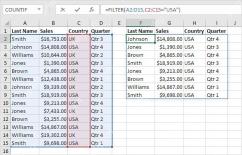
日常做表的时候,完全可以先把FILTER单独写到空白的辅助区域,确认输出结果没问题了,再把整个FILTER公式嵌进XLOOKUP里。这种分步排错,比你一口气写完所有嵌套公式要省心太多。

将 PySpark .show() 输出转为 Tab 分隔文本,方便粘贴 Excel。触发词:pyspark、数据转excel、表格整理、venus数据、show输出、复制到excel、数据格式化。
需要排序时先把候选结果整理好
要是你的查找需求还涉及「取最新一条、取金额最高、取优先级最高」这类规则,可以在FILTER后面叠加SORT或者SORTBY函数,把筛出来的候选结果按指定字段排好序。排序完成之后再取第一条或者找指定项目,整个逻辑会稳很多。
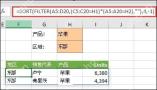
举个例子,要找指定客户最近一次的成交金额,先FILTER把这个客户的所有订单都筛出来,再按成交日期做降序排序。后面取值的时候完全不用在整张大表里绕来绕去,省事很多。
再用 XLOOKUP 从候选结果里取目标字段
等候选结果校验没问题了,再接上XLOOKUP就行。常规写法很简单:把XLOOKUP的查找区域和返回区域,全都指向FILTER输出的结果表就行。比如先筛出某地区的所有订单,再用订单编号查对应金额;或是先筛出某季度的全量数据,再按产品名取对应的负责人。
要是你嫌嵌套公式写出来太长不好改,完全可以留着辅助区域:一块放FILTER的筛选结果,旁边直接写XLOOKUP做查找。等整个逻辑跑通稳定了,再考虑用LET函数把整段公式整合到一起。做复杂查找最忌讳上来就想一步到位,分层验证反而效率高得多。
遇到错误时按两层排查
最后要是结果返回#N/A或者空白,分两步排查就行:先查FILTER部分,看看条件是不是写错了、数据类型有没有文本和数字混配的问题、筛选完是不是真的有符合条件的行。确认FILTER输出没问题,再回头查XLOOKUP:查找值是不是带了多余空格、查找列和匹配项是不是对得上、返回列有没有选错位。
把FILTER和XLOOKUP的分工理清楚,再做复杂查找根本不会乱。前者负责把全表范围收窄,后者负责精准定位取值;一个定好「哪些行允许进入候选池」,一个搞定「最终要挑哪一列的结果」。按这个顺序写公式,后期别人接手你的表格,也能一眼看懂逻辑。


