





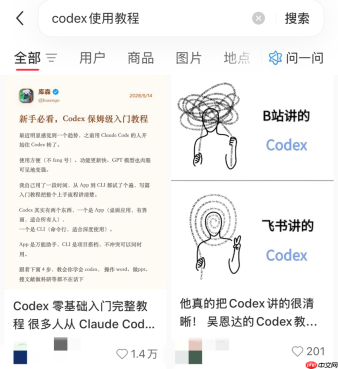
“codex手把手链接指南”“claude code零门槛环境搭建”,近段时间的社交平台中,分享海外ai agent使用教程已成为最热门的内容之一。
明明国内AI大模型生态异常活跃:豆包日活破亿级规模,DeepSeek将API调用成本压至令硅谷震惊的“地板价”,各大厂商“性能超越GPT-4”的宣传通稿铺天盖地。
按常理推断,在这场激烈内卷的国产大模型竞赛中,用户本应享有丰富、低价且顺手的本地化选择。然而大量国内用户却甘愿耗费时间精力、突破复杂的网络限制、每月支付不菲订阅费用,执着奔赴海外AI Agent阵营,甚至催生出一条隐秘运转的灰色服务链。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
▲ 注:图片源于小红书
这种割裂又耐人寻味的市场图景,不禁引人深思:当大模型迈入Agent新纪元,国产AI在国内用户心中“总觉得差点火候”,究竟是固有偏见作祟,还是中外AI之间确实横亘着难以忽视的技术代际鸿沟?
国产Agent:优势突出,短板尚存
事实上,结合主流评测榜单与真实用户反馈来看,过去三年间,国产大模型非但未全面掉队,反而在多个细分领域和关键指标上实现了弯道超车。
文本理解与生成能力,是检验大模型本土化深度与底层逻辑成熟度的核心标尺——语言不仅是符号系统,更是文化语境、思维范式与商业逻辑的复合载体。
GPT-5、Claude Opus等国际一线模型虽能流畅输出中文,但一旦进入深度创作场景,便极易暴露“翻译腔”痕迹。其表达结构更倾向西方线性逻辑,在处理中国人情社会特有的微妙分寸、或电商/政务类高度语境化的文本时,往往显得格格不入。
而国产AI Agent在中文语义感知与内容生成层面,则展现出天然适配优势。
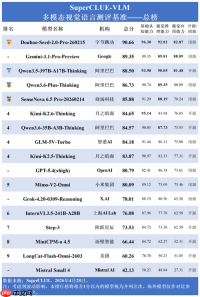
4月29日,SuperCLUE-VLM发布的2026年4月中文多模态视觉语言模型榜单显示,字节跳动旗下模型以90.66分登顶榜首;阿里Qwen3.5系列、商汤SenseNova、智谱GLM等国产主力亦稳居前列;OpenAI的GPT-5.4、X.AI的Grok等海外明星模型仅位列中游。
▲ 注:图片源于新浪财经
国产大模型在中文场景中的强势表现,根源在于海量高质量本土语料的持续投喂,以及与中国互联网生态的深度耦合。
无论是撰写深谙职场潜规则的年度述职报告,还是产出“家人们、速抢!”这类节奏感极强的直播带货话术,国产模型都能精准捕捉语感起伏与网络热梗情绪,这是当前海外产品尚未企及的能力边界。
不仅如此,在超长文本解析与代码推理等硬核维度,国产基座同样展现出强劲竞争力。
当海外旗舰模型普遍仍徘徊于128K–200K上下文窗口时,Kimi已将无损文本承载量拉升至200万字级别;通义千问Qwen3-Max更突破至1000万字容量——意味着国产Agent可一次性加载数十页行业研报、整套法律案卷等高密度中文材料,并完成跨段落比对与关键信息抽取。
而曾被海外巨头视为护城河的编程与数理逻辑能力,如今也正被DeepSeek V4 Pro、豆包2.1 Pro等国产力量加速填补。
6月23日,字节跳动正式推出豆包大模型2.1系列,在Terminal Bench 2.1、SWE-Pro、SciCode等九大权威测评中,豆包2.1 Pro多项指标反超Anthropic旗舰Claude Opus 4.7,全面跻身全球第一梯队。
不过局部亮点虽多,一旦AI Agent的能力边界从纯文本/代码向物理世界交互与多模态视觉延伸,国产模型与海外头部之间仍存在明显差距。
今年4月,OpenAI发布GPT Image 2,上线数小时内即以断层优势登顶Image Arena文生图排行榜,不仅具备自主任务拆解、构图规划与结果自检能力,还可直接生成符合中文排版规范的图文内容;而同期国内主流模型在图像质感、物理规律建模及空间逻辑一致性方面,仍频繁出现明显瑕疵。
对于瞄准复杂工作流接管的下一代Agent而言,多模态能力的滞后,不仅影响视觉内容质量,更深层制约其理解操作系统桌面GUI、处理跨软件视觉输入,乃至未来驱动具身智能体的底层基础。
这种核心多模态架构上的结构性失衡,构成了用户使用中外大模型时的第一重体验落差。
路径差异,塑造Agent真实体感
当大模型从对话框跃迁为智能体,相比底层技术的长短项,海内外厂商在AI落地路径上的战略抉择,才是真正决定用户日常体验的关键变量。
以OpenAI、Anthropic为代表的海外AI领军者,始终锚定通用人工智能(AGI)愿景——在其蓝图中,Agent并非局限于网页端的问答助手,而是具备高度自主性、能调用人类全部数字工具的“硅基协作者”。
Codex近期正式上线计算机操控功能,不再依赖传统API接口,而是凭借强大视觉多模态能力“读懂”屏幕每一像素,像真人一样移动鼠标、点击图标、敲击键盘。

当用户下达包含数据清洗、交叉分析与邮件发送等多重步骤的复合指令后,它不会仅返回一段操作指引或代码片段,而是直接在本地桌面自动启动Excel读取表格、运行Python脚本处理数据、再调用Outlook发送报告给指定联系人,真正实现端到端全自动闭环。
在此路径下,用户感知的不再是聪明的搜索引擎,而是能探讨系统架构、自主拆解任务链路、甚至具备独立反思与纠错能力的“数字合伙人”。
据OpenRouter公开数据,2026年5月,搭载自我反思机制的Hermes Agent单日Token消耗达2910亿,印证了大量用户正深度使用这类脱离聊天框、可执行长链路任务的智能体。
反观国内AI Agent赛道,依托微信、飞书、抖音、淘宝等全球独有的超级应用生态,国内大厂从起步阶段便将Agent明确定位为商业化效率工具。
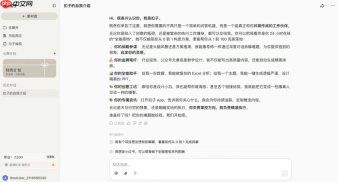
字节跳动扣子平台已集成超2000个官方插件,可视化编排能力极为成熟,零代码小白也能轻松搭建Bot;腾讯WorkBuddy接入技能包超8万个,月访问量高达885万,深度打通企业微信与腾讯文档体系。
▲ 注:图片源于扣子
它们广泛服务于电商运营、营销文案、公文写作、PPT制作等ToB刚需场景,在特定业务闭环内显著压缩重复性人力投入。
但即便插件生态繁荣,国产Agent在产品形态上仍未跳出聊天框框架。面对需跨越多个本地软件的系统级复杂任务,它无法如Codex般直接接管鼠标执行,更多提供操作建议或代码模板。
用户满怀期待想雇佣一位能深入底层、完成繁复操作的“深度合伙人”,最终得到的却是一位仪态得体、话术标准,却只能在限定网页内读文档、写材料的“实习生助理”。
商业模式,定义Agent能力上限
技术路线的分野,终将在商业现实中兑现。抛开宏大技术叙事,真正决定Agent是“真智能”还是“伪聪明”的终极变量,其实藏在服务器后台的算力账单里。
真正可用的Agent绝非简单接收Prompt并输出答案,一个成熟Agent后台至少包含任务规划、执行调度、状态记忆、校验回滚四大模块。每次闭环运行均消耗海量Token,看似简单的代码调试任务,背后可能已进行数十轮自我博弈与API调用。
在算力持续高压消耗前提下,海外市场成熟的软件付费习惯,成为支撑Agent“深思熟虑”的底层底气。
面向C端,ChatGPT Plus与Claude Pro订阅费高达20美元/月,仍吸引大量用户付费——截至今年3月,ChatGPT周活跃用户突破9亿,其中付费用户约5000万;Semi Analysis报告显示,Anthropic年化营收较2025年底增长近五倍,增长引擎正是Claude Code的亮眼表现及企业需求爆发。
用户付足费用,海外厂商才敢放开后台算力供给,高客单价赋予Agent长程记忆管理与多轮自我纠错的空间,从而保障任务闭环稳定性。
但转回国内市场,为争夺C端流量入口,头部大厂的Agent应用几乎全线采用免费策略,API价格战更是愈演愈烈。
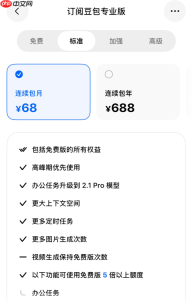
2026年4月,DeepSeek将V4-Pro输入定价压至3元/百万Token,输出仅6元/百万Token,约为GPT-4o报价的十二分之一;即便是开始推进收费的豆包专业版,标准月费也仅为68元,学生优惠价低至38元。
▲ 注:图片源于豆包
当产品客单价被极致压缩、甚至无法覆盖Agent推理成本时,国内厂商为控制服务器开支、维持运营可持续性,不得不在后台实施工程级算力妥协,或大幅削减中长期记忆保留轮次。
缺乏后台验证与纠错机制的Agent,在遭遇未成功调用的API或检索失败的数据时,不会反复尝试修正,而是以不容置疑的语气输出错误结论,甚至陷入幻觉式胡言乱语。
因此,进入Agent时代,国产产品在用户口碑中的体验落差,并非单纯算法能力不足所致,而是一个融合技术偏好、发展路径与商业模式限制的系统性课题。毕竟据斯坦福大学《2025人工智能指数报告》显示,中美顶尖大模型性能差距已从2024年1月的9.3%,收窄至2025年2月的1.7%。
未来若要真正弥合这“最后一公里”的体验代差,国产Agent或许更需聚焦从业务流程到商业闭环的重构路径,构建可持续的盈利模式以支撑算力消耗,让中国AI Agent挣脱低价甚至免费枷锁,成长为值得托付的“数字合伙人”。
图片源于网络,侵删。
本文来自微信公众号“壹度Pro”,作者:文波,36氪经授权发布。









