





近日,业内曝出重磅人事消息:openai 前研究员田永龙(yonglong tian)已正式加盟腾讯,预计将牵头负责腾讯混元多模态模型方向,并全面主导视觉语言模型(vlm)的研发进程。尽管官方尚未发布正式公告,但该消息已在ai圈内引发高度关注与热议。若此次任命最终落地,田永龙将成为继姚顺雨之后,腾讯混元团队引入的又一位具备顶尖工业界与学术背景的核心技术领军人物。
田永龙的加入,进一步印证了腾讯在多模态大模型赛道上的战略纵深与持续投入。他与腾讯现任首席 AI 科学家姚顺雨曾同在 OpenAI 共事,共同参与并亲历了 GPT 系列模型及多模态技术的关键演进阶段。作为计算机视觉领域公认的青年领军学者,田永龙履历扎实:本科就读于清华大学,硕士毕业于香港中文大学 MMLab,博士阶段则在麻省理工学院(MIT)完成深造。其研究路径清晰呈现从经典视觉识别向生成式建模与表征学习的跃迁,目前 Google Scholar 引用量已逼近 3 万次。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
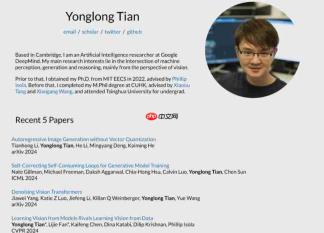
学术方面,田永龙成果斐然。他首创的“有监督对比学习”(Supervised Contrastive Learning)方法,成功将对比学习范式拓展至监督学习场景,极大推动了视觉预训练模型的设计范式革新。近年来,他的研究重点聚焦于自回归图像生成方向,尤其在 Fluid 系列工作中,通过实证验证连续 token 表征在图像生成质量上的显著优势,为大模型视觉生成能力开辟了全新技术路径。在加入腾讯前,他曾长期任职于 Google Research 与 Google DeepMind,并于后期加入 OpenAI 担任核心研发成员。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
本次人才引进,是腾讯混元多模态团队近一年来组织升级与梯队建设的关键落子。自2025年4月腾讯正式成立大语言模型部与多模态模型部以来,团队持续加速整合资源、优化架构。此前,已陆续吸纳来自微软亚洲研究院、阿里巴巴达摩院、清华大学等顶尖机构的多位资深科学家与工程专家,旨在破解过往“研发力量分散、协同效率不足”的瓶颈,打造更高效、更闭环的多模态技术研发体系。
随着田永龙等一批重量级技术专家的陆续加入,腾讯混元在多模态理解、跨模态对齐及视觉感知等关键能力上的攻坚实力有望实现质的飞跃。作为全球AI第一梯队的重要参与者,腾讯正以系统性的人才拼图策略,加速构筑其在混元模型多模态能力维度的技术护城河与长期竞争力。





