





智东西6月27日报道,继成功完成500亿元融资后,今日,deepseek首次公开其最新开源成果!
就在刚刚,DeepSeek正式推出一套显著提升现有大模型推理效率的工程级优化方案:发布DeepSeek-V4-Pro-DSpark、DeepSeek-V4-Flash-DSpark两个增强版模型,并同步开源推测解码(Speculative Decoding)框架DSpark与专用训练框架DeepSpec。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
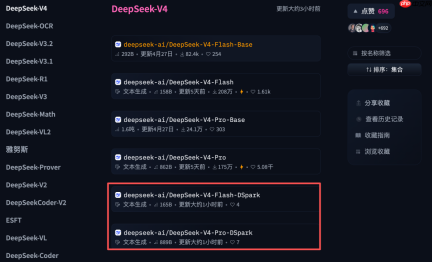
▲DeepSeek-V4-Pro-DSpark开源上新页面截图
据同步发布的、由梁文锋领衔并联合北京大学团队完成的论文《DSpark:基于半自回归生成的置信度调度推测解码(DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation)》显示,当DSpark部署于DeepSeek-V4线上服务系统并承载真实用户请求时,可大幅削减因无效校验导致的算力损耗。
相比当前成熟的生产基线方案(MTP-1),在整体吞吐量维持不变的前提下,DSpark将单用户响应速度提升60%至85%。尤为关键的是,在严苛的端到端延迟约束下,DSpark成功规避了高并发场景中吞吐率的断崖式下跌,达成了此前难以企及的性能水平,实质性拓展了整套推理服务系统的帕累托最优边界。
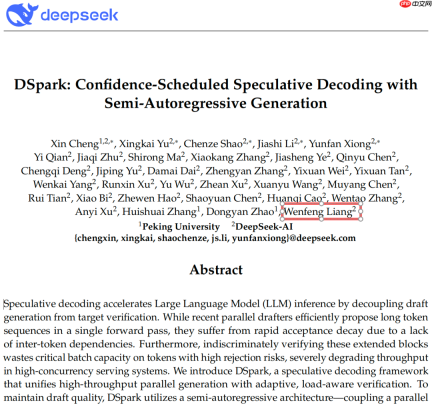
▲DSpark论文截图
Hugging Face地址:
https://www.php.cn/link/af92a5343490e6d0e1ab7ff3ede87c47
GitHub地址:
https://www.php.cn/link/cf5a0f1371aa30a9f080f64baf566edd
论文地址:
https://www.php.cn/link/cf5a0f1371aa30a9f080f64baf566edd/blob/main/DSpark\_paper.pdf
根据Hugging Face平台上的模型说明文档,DeepSeek-V4-Pro-DSpark与DeepSeek-V4-Flash-DSpark并非全新架构模型,而是在原有V4版本基础上,集成了一套轻量高效的推测解码模块,旨在加速推理过程、降低单位计算成本。
所谓推测解码,本质上是一种零精度损失的大模型推理加速技术,其核心逻辑为“先快速起草、再精准验证”。该方法将草稿生成与主模型校验分离,从而突破传统自回归解码的序列瓶颈。
当前主流并行草稿器虽能单次前向传播输出长序列token,但由于各token间缺乏依赖建模,越靠后的token被主模型接受的概率越低;若对整段候选序列进行无差别验证,则极易将宝贵批处理资源浪费在高拒绝率的尾部token上,最终拖累大规模服务场景下的整体吞吐表现。
为此,DeepSeek设计出DSpark推测解码框架,将高吞吐并行生成能力与动态感知负载的智能校验机制深度融合。为保障草稿质量,DSpark采用创新的半自回归结构:融合并行主干网络与轻量级串行子模块,在模块内部构建token间局部依赖关系,有效缓解末段内容通过率骤降问题。
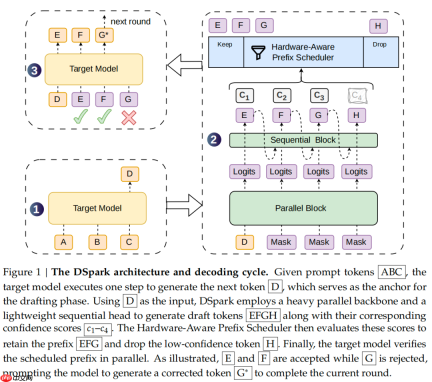
▲DSpark架构与解码流程
为进一步提升系统运行效能,DSpark引入置信度驱动的动态校验长度调度机制:依据预估的前缀接受概率及实时引擎吞吐状态,为每条请求智能分配最优校验长度。在多领域离线基准测试中,DSpark相较当前最优的自回归与并行草稿器方案,均展现出更长的有效通过序列长度。
如下图所示,DeepSeek为DeepSeek-V4-Pro-DSpark和DeepSeek-V4-Flash-DSpark两款模型提供了极简可用的推理示例代码。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
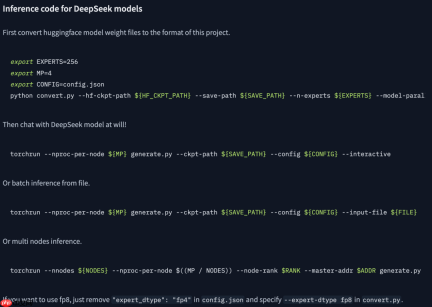
▲DeepSeek提供的最小推理示例
总体而言,用户在部署搭载DSpark的DeepSeek-V4模型后,有望在生成延时、首token响应时间、并发处理能力等多个维度获得明显体验升级。
再来看DeepSpec——这是一套面向推测性解码草稿模型(Draft Model)的全栈式训练与评估工具链,涵盖数据构建、模型实现、训练脚本及评测模块,完全开源且采用MIT许可证。
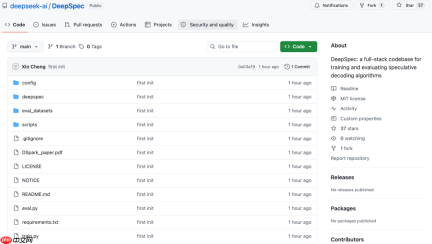
▲DeepSpec开源上新页面截图
DeepSpec的标准工作流按阶段顺序执行,前一阶段输出作为下一阶段输入,形成闭环反馈:
1、数据准备:自动下载提示样本,重生成目标答案,并构建高质量目标缓存。
2、训练:基于缓存的目标输出,对草稿模型进行监督训练。
3、评估:在标准基准任务上量化推测解码的token接受率与整体效率。
目前,DeepSpec已原生支持三大草稿模型算法:DSpark、DFlash与Eagle3。
DeepSpec团队还在文末特别致谢SpecForge(Apache-2.0)、DFlash(MIT)以及Qwen3和Gemma项目。
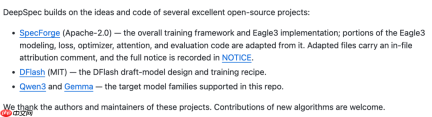
▲DeepSeek致谢情况
由此可见,DeepSeek此次不仅开放了适配自身模型的增强版本,更提供了一套通用性强、开箱即用的训练基础设施,开发者与企业可直接利用DeepSpec为Qwen3、Gemma等第三方大模型定制专属草稿模型。
结语:推理正成为新战场
工程实力决定落地成败
尽管本次发布风格低调,且未涉及模型架构迭代,但其技术价值不容小觑。DeepSeek推出的是一套真正面向工业级部署的推理加速工程方案,不仅能带来更快速、更经济的生成体验,也显著降低了推测解码技术的工程应用门槛。
大模型竞争已迈入训练能力与推理效能双轮驱动的深水区。此次动作,正是DeepSeek在完成巨额融资后,率先卡位推理优化赛道的关键落子。战略指向清晰可见:既要加快模型迭代与产品化进程,更要向下扎根,在算力利用效率这一底层战场上构筑长期护城河。
本文来自微信公众号 “智东西”(ID:zhidxcom),作者:李水青,36氪经授权发布。



