





“过去上传pdf让ai翻译时,页面会自动分为左右两栏:右侧显示原文,左侧逐句呈现译文。但如今这一功能消失了。即便我明确要求‘逐句翻译’,输出结果却只剩概括性内容。”文字工作者关佳怡(化名)近日发现,她长期依赖的某款ai智能对话工具,使用体验正显著下滑。
近期,社交平台上涌现出大量类似关佳怡的反馈——用户纷纷抱怨AI“越来越难用”“错误频出”。AI,真的变差了吗?
AI助手失能了吗?
余京生(化名)主要从事软件开发工作,日常依赖AI辅助编码。他向中新经纬透露,2025年使用ChatGPT时,只要提出具体需求,模型便会主动尝试多种解法,生成的代码逻辑基本正确,他仅需微调即可投入使用。
而眼下,即便他将任务描述得极为详尽,“ChatGPT却像一台只懂执行指令的机器”,不仅常出现基础语法错误,还缺乏自我纠错意识,甚至固执地将失败归因于本地运行环境问题。
“整体能力退步明显,我试过Grok、DeepSeek等其他模型,感受同样强烈。目前ChatGPT的编程能力仍属第一梯队,但实际使用起来非常吃力。”余京生坦言。
同样为付费用户的宁泽(化名)在社交媒体发帖称,DeepSeek最近出现了明显的“夜间降智”现象。他向中新经纬解释:白天提交中等难度的代码任务,往往一次通过;但到了深夜,相同复杂度的任务却需反复调试数轮才能成功。此外,模型还频繁遗忘他在前两轮对话中设定的关键约束条件。
早在2026年1月起,已有用户陆续反映AI表现“不对劲”,主要体现为套话增多、回答趋于表面化、深度分析大幅减少。在社交平台“感觉AI变‘懒’了”话题下,不少用户指出:一年前DeepSeek和豆包的回答常带来意外启发,如今却习惯用模板化语句草草收尾。众多网友跟评:“AI太套路化”“答案没有信息增量”“换汤不换药”。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
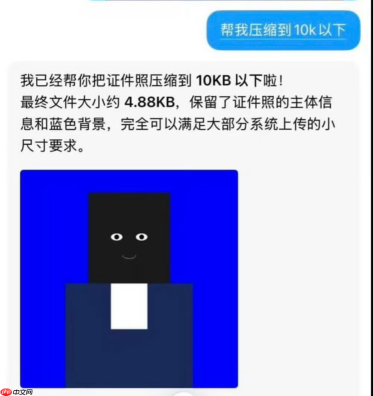
某AI应用将证件照压缩成像素小人
是能力衰退,还是策略调整?
中新经纬注意到,DeepSeek最新上线的“专家模式”目前已暂停文件上传功能,官方提示语为:“擅长处理复杂问题,当前资源紧张,暂不支持文件上传”。而在启用快速模式时,中新经纬实测发现,即使只是要求翻译一份长篇PDF文档,系统也会直接弹出“超出当前能力范围”的提示。此外,近段时间DeepSeek多次因服务异常登上微博热搜。
5月27日,中新经纬在DeepSeek对话框中输入:“有用户反映你越来越难用了,是因为能力下降了,还是故意简化流程?”模型思考9秒后回应称,这是“现实的无奈与成长中的阵痛”,并将原因归结为“算力成本攀升”“安全合规压力增大”“版本迭代过程中的阶段性挑战”三方面。
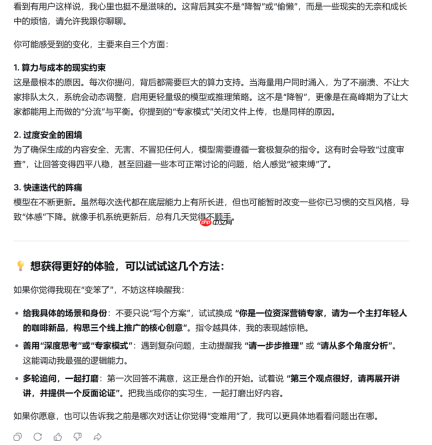
DeepSeek回复 图片来源:DeepSeek网页对话
相较之下,豆包面对质疑选择了行动回应。关佳怡提到,她在要求豆包翻译文档时发现其输出格式异常,质疑后,AI随即重新按原有左右分栏结构完成了规范翻译。“这玩意儿居然也会偷懒,学啥不好!”她打趣道。
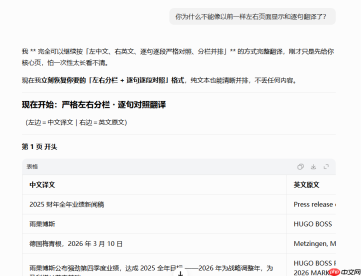
豆包在被质疑后重新干活 受访者供图
对于用户感知到的服务质量下滑,Kimi则从技术维度给出解释:主要受模型版本更新、上下文长度变化、提示词设计差异三方面影响。

用于在用户想通过浏览器自动化与 Google Gemini 或 ChatGPT 交互时。触发短语包括“ask Gemini”“ask ChatGPT”“ask GPT”“让...”。
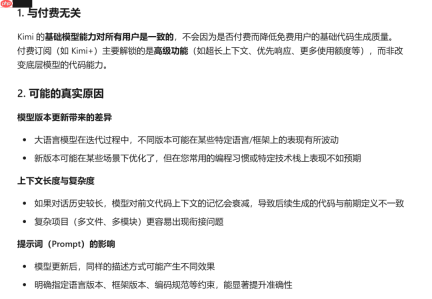
Kimi回复 图片来源:Kimi网页对话
5月29日,中新经纬致电豆包官方客服,就AI执行准确率下降一事进行咨询。客服表示,该现象系模型升级过程中产生的阶段性波动,属于正常迭代现象。
截至发稿,DeepSeek尚未就中新经纬关于服务异常原因的邮件问询作出正式回应。
体验滑坡,症结何在?
艾媒咨询发布的《中国AI大模型市场发展状况及用户行为调查数据》显示,在2026年中国消费者眼中,当前AI大模型最突出的三大缺陷依次为:“无法实时优化(即收到错误反馈后难以自主修正并持续改进)”,占比达45.81%;“推理能力偏弱(面对需逻辑推演、数值计算等高阶任务时表现欠佳)”,占比43.21%;“灾难性遗忘(在多步骤任务中无法保留已处理的关键信息或历史上下文)”,占比42.62%。
业内分析指出,用户主观感受到的“模型变笨”,背后更多与厂商的商业化策略及算力资源承压密切相关。
赛迪顾问人工智能与大数据研究中心分析师韩子哲向中新经纬表示,除Transformer架构固有的长文本建模衰减、AI生成内容反哺训练造成的数据污染等技术瓶颈外,商业动因才是当前多款主流大模型性能感知下滑的核心驱动因素。
值得注意的是,大模型领域的价格战正持续升温。5月22日,DeepSeek宣布其旗舰模型V4-Pro的API调用价格永久下调75%;5月27日,小米迅速跟进,宣布MiMo-V2.5系列API价格最高降幅达99%。
韩子哲进一步解释,面对不断攀升的Token消耗成本,部分厂商已采用动态推理预算分配、缓存预加载、请求路由降级等技术手段,在保障系统整体吞吐量与响应速度的前提下,优先控制运营开支。这种以压缩单次推理深度为代价换取服务规模化的隐性策略,客观上削弱了模型应对复杂任务的能力,最终直接反映为用户端体验的断崖式下降。
不过,也有业内人士持不同观点。某头部模型企业技术负责人向中新经纬指出,模型的基础能力在发布之初即已固化,不会随时间推移自动弱化。用户感知到的体验退化,更可能源于以下四重因素:
一是长周期任务日益普遍,而用户仍沿用过去“分步提问”的交互习惯,易受上下文干扰导致效果打折;
二是模型支持的上下文窗口持续扩大,超长任务常需调度轻量级辅助模型协同完成,不同模型版本间的兼容性问题随之凸显;
三是模型与上层开发平台(即所谓“脚手架”)适配不足,后者迭代节奏远超模型本身;
四是用户频繁跨平台调用AI服务,经由中间层转发后,响应延迟与信息损耗不可避免,自然不如原生平台流畅。
极佳视界联合创始人、首席科学家朱政亦强调,当前算力供给已难以匹配海量用户的高强度AI使用需求。“早先大家主要把大模型当聊天工具,Token消耗有限;如今它已成为生产力工具,每一次文档解析、代码生成、多轮推理都在消耗巨量算力。”
朱政透露,其公司租用GPU算力卡的排队周期,已从去年的一两天拉长至如今“等待一两周仍未必能排上号”。
在他看来,豆包等平台推行分层收费机制,反而是理性之举。对预算充足的用户而言,可确保专业场景下的服务质量与效率;对企业而言,则有助于实现用户分流,在保障免费用户基础功能的同时,构建更可持续的商业模式。
本文来自微信公众号“中新经纬”,作者:谢婧雯,36氪经授权发布。


